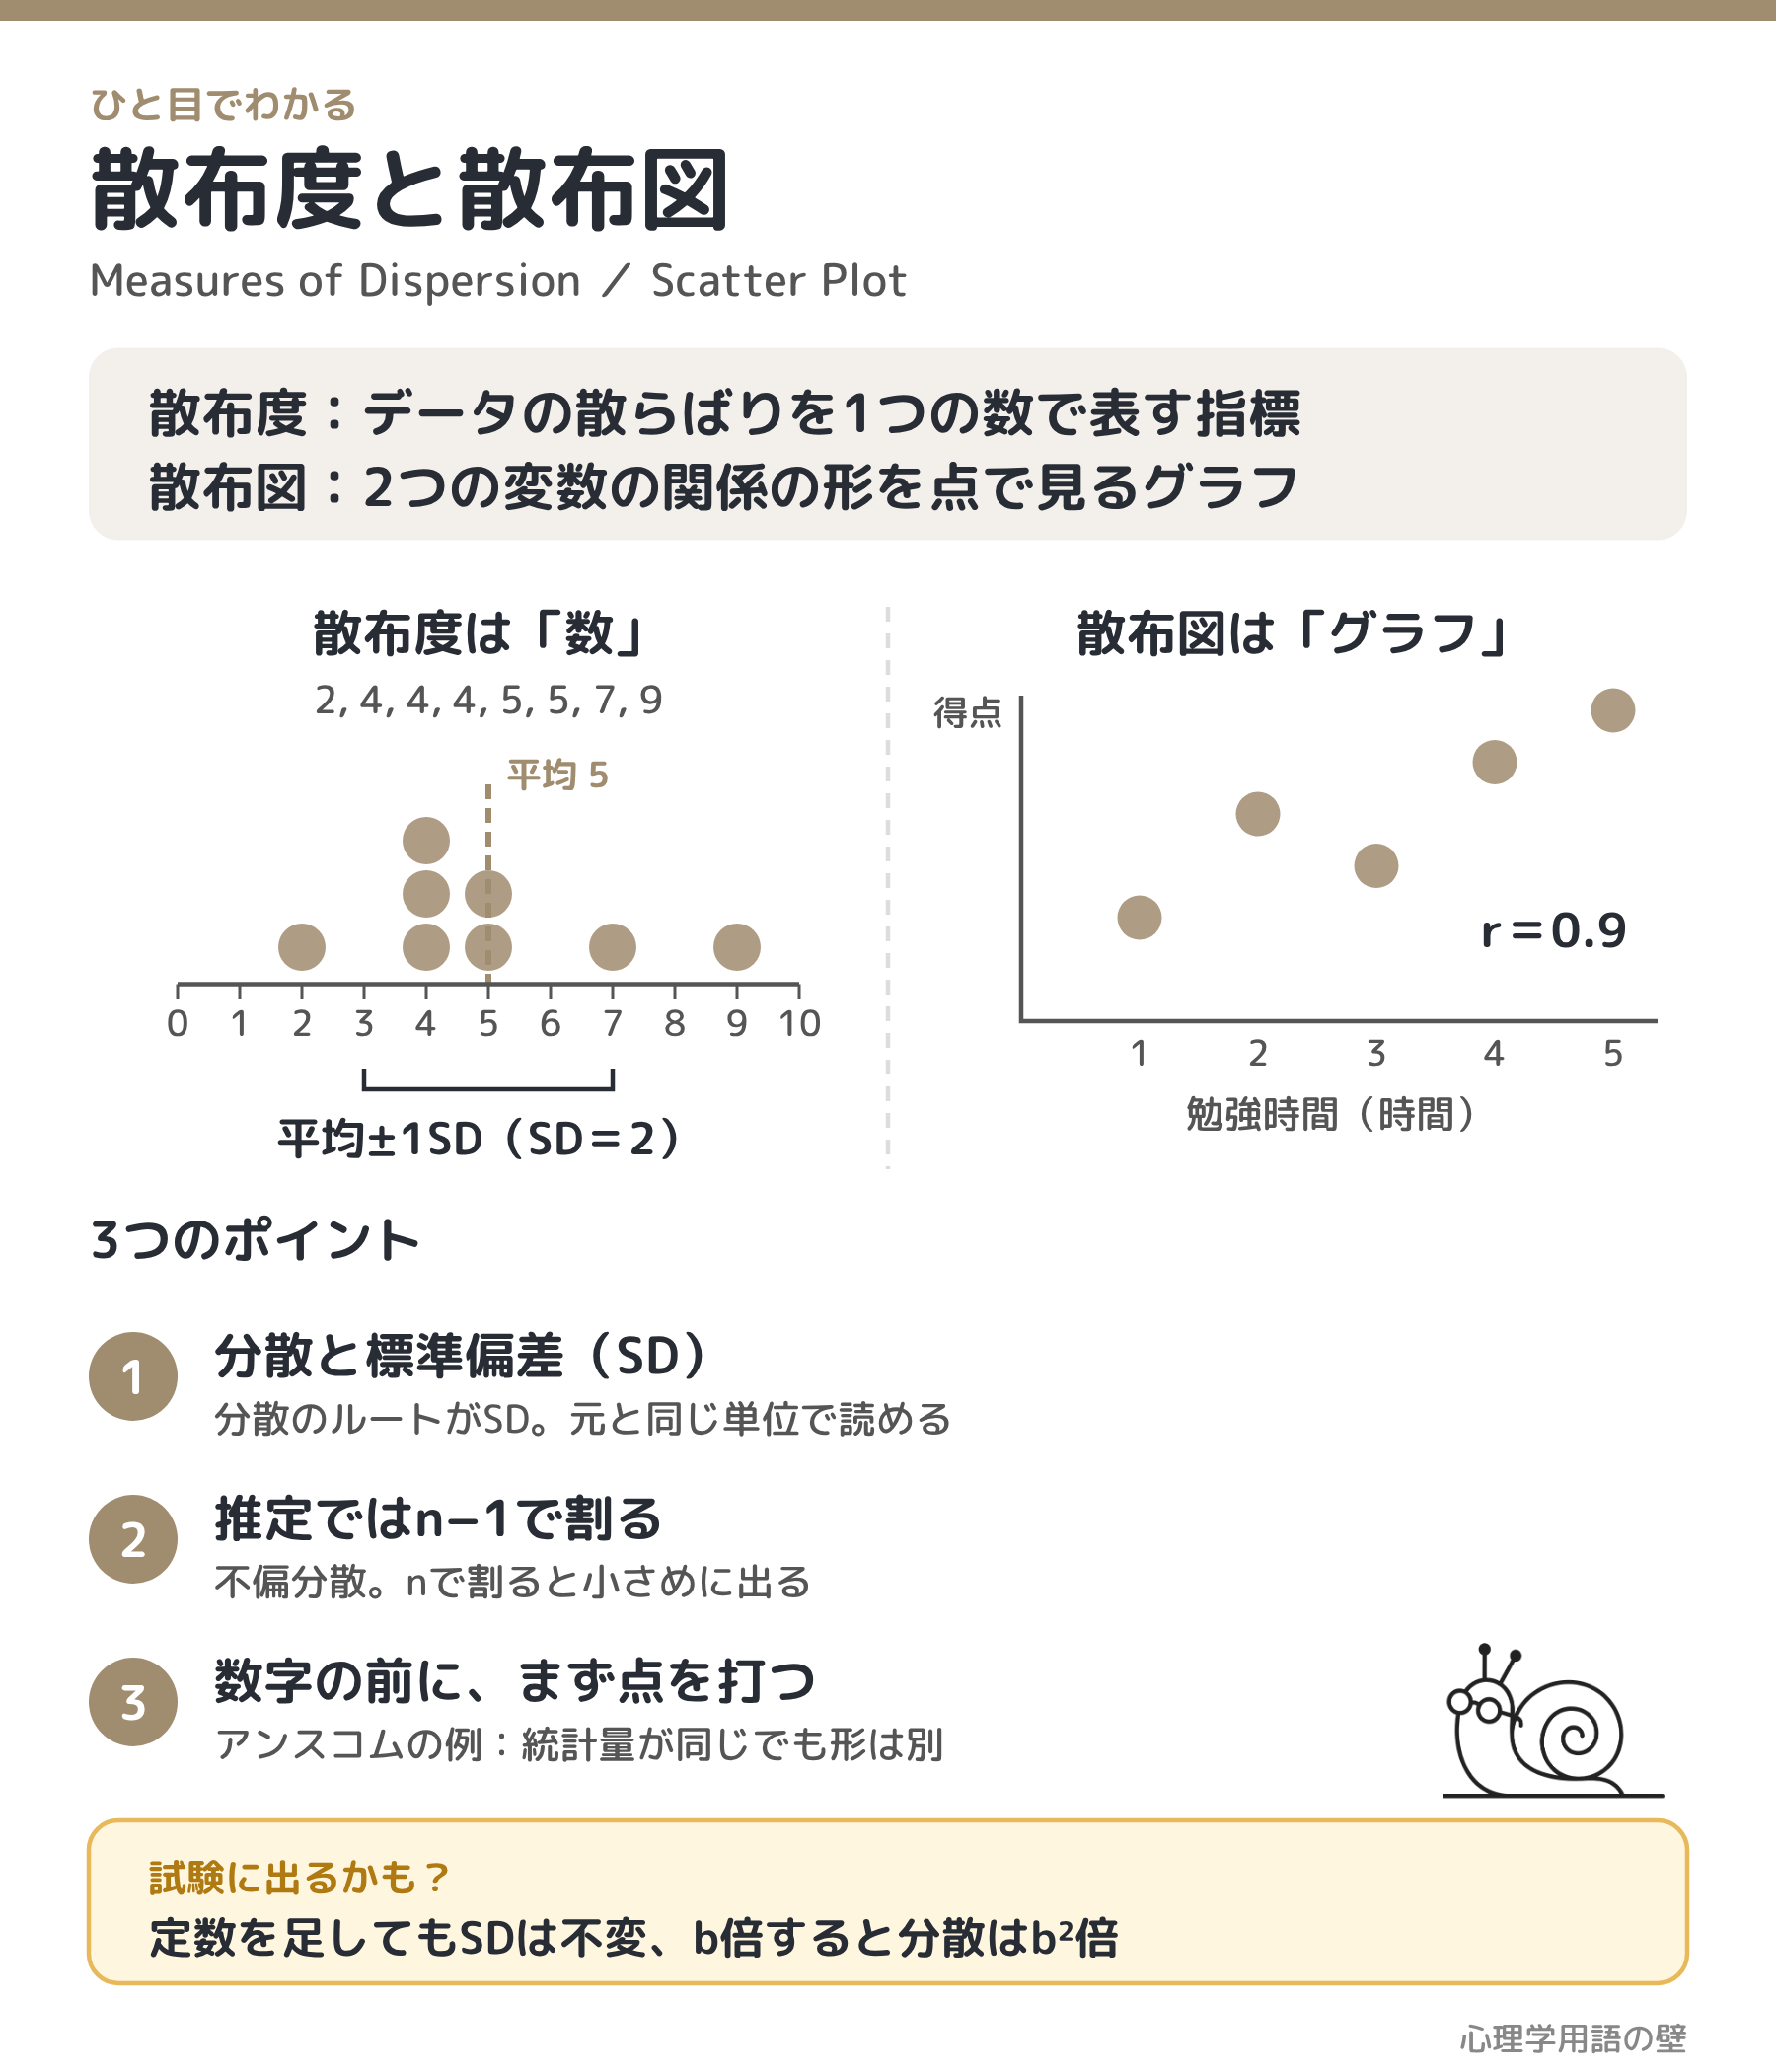
散布度(Measures of Dispersion)とは、データが平均などの中心のまわりにどれくらい散らばっているかを1つの数で表す指標です。散布図(Scatter Plot)は、2つの変数の値を点で描き、2つの関係の形を目で確かめるグラフです。
簡単な説明
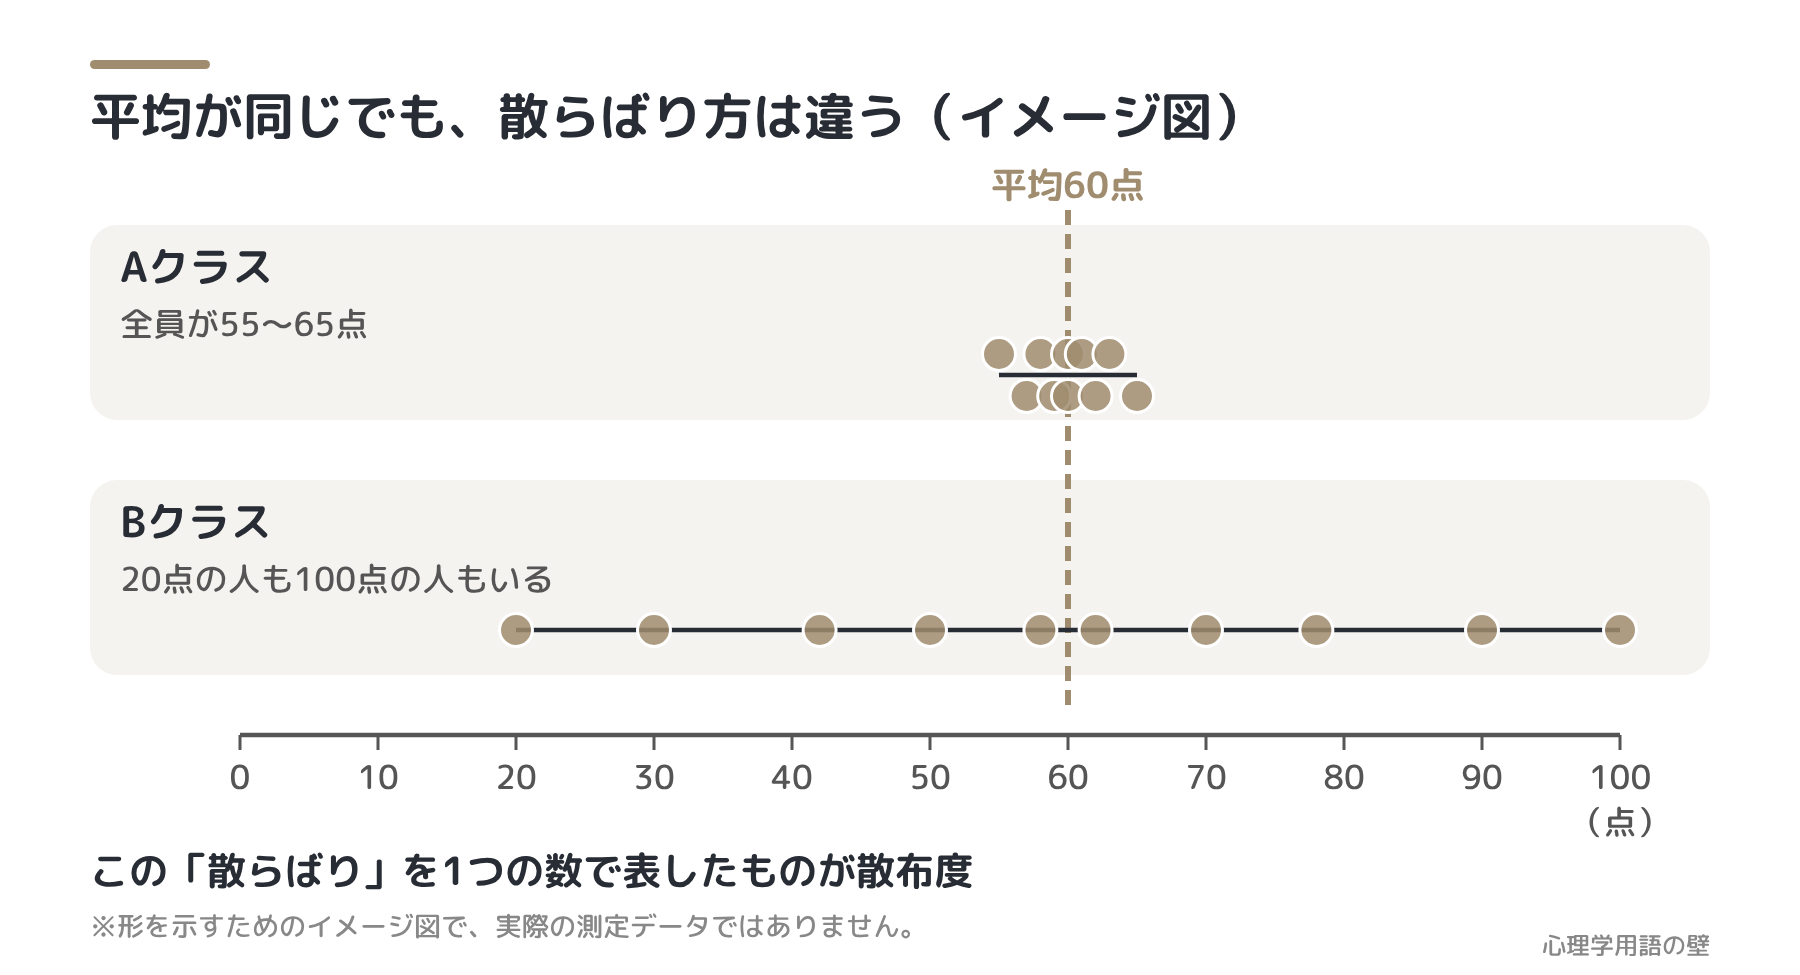
2つのクラスで、テストの平均点がどちらも60点だったとします。でも、Aクラスは全員が55〜65点、Bクラスは20点の人も100点の人もいる、ということがありえます。平均が同じでも、散らばり方はまったく違うのです。この「散らばり」を数で表したものが散布度です。
一方、「勉強時間が長い人ほど点数が高いか」を知りたいときは、1人を1つの点として、横に勉強時間、縦に点数をとって点を打ちます。これが散布図です。点が右上がりに並べば「長いほど高い」傾向がある、とひと目でわかります。名前は似ていますが、散布度は「数」、散布図は「グラフ」です。
由来
| 年 | 主なできごと |
|---|---|
| 1886年 | Francis Galtonが、親と子の身長の関係を調べた論文を発表。Galtonによる散布図の利用が相関と回帰の発見につながった(Friendly & Denis, 2005) |
| 1893〜94年 | Karl Pearsonが、1893年に発表し翌年Philosophical Transactionsに載った論文で、正規曲線の散らばりを標準偏差(standard deviation)と呼ぶと定める |
| 1918年 | Ronald A. Fisherが遺伝の論文で、標準偏差の2乗を分散(variance)と名づける |
| 1973年 | Francis J. Anscombeが、統計量がほぼ同じなのに散布図がまったく違う4組のデータ(アンスコムの例)を発表 |
具体的な説明
おもな散布度
心理学のデータは、同じ条件でも人によって値が違います。この個人差の大きさを要約するのが散布度です。データ「2, 4, 4, 4, 5, 5, 7, 9」(8人、平均5)で計算してみます。
| 指標 | 求め方 | 例の値 | 特徴 |
|---|---|---|---|
| 範囲(レンジ) | 最大値−最小値 | 9−2=7 | 簡単だが両端の値だけで決まり、外れ値に弱い |
| 四分位範囲 | 第3四分位数−第1四分位数 | 6−4=2 | 真ん中50%の幅。外れ値に強い。半分にしたものが四分位偏差(例では1) |
| 分散 | 偏差(値−平均)の2乗の平均 | 32÷8=4 | 単位が元の2乗(点²)になる |
| 標準偏差(SD) | 分散の正の平方根 | √4=2 | 元のデータと同じ単位で読める |
| 変動係数(CV) | 標準偏差÷平均 | 2÷5=0.4 | 単位や平均の大きさが違うデータの散らばりを比べられる |
偏差は−3, −1, −1, −1, 0, 0, 2, 4で、合計はかならず0になります。そのため、偏差をそのまま平均しても散らばりは測れず、2乗してから平均するのが分散です。四分位数は、ここではデータを下半分(2, 4, 4, 4)と上半分(5, 5, 7, 9)に分け、それぞれの中央値をとりました。求め方には流儀がいくつかあり、ソフトによって値が少し変わることがあります。
nで割るか、n−1で割るか
上の分散は、偏差の2乗和を人数nで割りました。手元のデータを記述するだけならこれで十分です。しかし、標本から母集団の分散を推定するときにnで割ると、平均すると小さめに出てしまいます。そこでn−1で割ったものを不偏分散と呼び、その期待値は母分散に一致します。例では32÷7≒4.57、その平方根は約2.14です。なお、不偏分散の平方根は、母標準偏差の厳密な不偏推定量ではありません。「標本分散」がどちらを指すかは教科書で違うので、分母で確かめましょう。
標準偏差と変動係数の読み方
データが正規分布に近ければ、平均±1SDに全体の約68%、±2SDに約95%が入ります(確率分布の記事も参照)。また、値から平均を引いてSDで割ったものが標準得点(z得点)で、偏差値は50+10zです。
変動係数は、たとえば身長(平均160cm、SD 8cm → 0.05)と体重(平均50kg、SD 6kg → 0.12)のように、単位の違う量の散らばりを比べるときに使います(数値は説明用の仮の値)。ただし、0が「まったくない」を意味する比率尺度でないと意味をもちません(摂氏の気温などは不可)。
散布図の読み方
散布図では、①向き(右上がり=正の相関、右下がり=負の相関)、②強さ(直線のまわりへの点の集まり具合)、③形(直線か曲線か)、④外れ値の4点を見ます。直線的な関係の強さを−1〜+1で表すのがピアソンの積率相関係数 rで、2変数の共分散を、それぞれの標準偏差の積で割って求めます。
例として、5人の勉強時間x(1, 2, 3, 4, 5時間)と小テスト得点y(2, 4, 3, 5, 6点)では、どちらも平均からの偏差の2乗和が10、偏差の積の和が9なので、r=9÷√(10×10)=0.9です。
| 注意点 | 内容 |
|---|---|
| 曲線的な関係 | U字型の関係があっても、rは0に近くなることがある。r=0は「直線的な関係がない」という意味 |
| 外れ値 | 1点だけで、rが大きく上がったり下がったりする |
| 範囲の制限 | 合格者だけなど、値の範囲をしぼって集めると、|r|は小さくなりやすい(切断効果・選抜効果) |
| 因果 | 相関があっても、どちらが原因かは決まらない。第3の変数が両方に影響している場合もある |
| 単位の変更 | 正の数をかけたり、定数を足したりしてもrは変わらない(負の数をかけると符号だけ逆になる) |
検定で問われやすいポイント
| 論点 | 押さえること |
|---|---|
| 全員に定数を足す | 平均は同じだけ動くが、散布度(範囲・SD・分散)は変わらない |
| 全員をb倍する | SDと範囲は|b|倍、分散はb²倍 |
| 尺度水準 | 順序尺度なら四分位範囲、間隔・比率尺度ならSDも使える。CVは比率尺度のみ |
実験や観察の方法と結論
Anscombe(1973)は、11組ずつのx・yからなる4つのデータセットを作りました。4つとも、xの平均9・不偏分散11、yの平均約7.5・不偏分散約4.12、相関係数約0.82、回帰直線 y=3+0.5x がほぼ一致します。ところが散布図にすると、1つめはふつうの直線的な関係、2つめはきれいな曲線、3つめは1点の外れ値以外が一直線、4つめはxがほぼ全部同じ値で、1点だけで相関が生まれている形でした。
結論は、要約統計量だけでデータを判断せず、まず図を描くべきだということです。Matejka & Fitzmaurice(2017)は、平均・SD・相関係数が小数第2位まで同じで散布図は恐竜形などまったく違うデータを、コンピュータで作る方法を示しました。
例文
「2つの指導法で平均点は同じでしたが、新しい指導法のほうが標準偏差が小さく、得点のばらつきが少ないことがわかりました。」
「相関係数は0.1と低かったのですが、散布図を描くと逆U字型の関係が見られたため、曲線的な分析を検討しました。」
疑問
Q: 偏差を2乗せずに、絶対値の平均を使ってはいけないのですか?
A: 使ってもかまいません。偏差の絶対値の平均は平均偏差と呼ばれる散布度です。ただ、分散には「独立な変数の和の分散は、それぞれの分散の和」などの扱いやすい性質があるため、推測統計では分散とSDが中心です。
Q: レポートの標準偏差は、nとn−1のどちらで割ればよいですか?
A: 心理学の研究は、集めた人を母集団の標本と考えることが多いため、n−1で割った値(統計ソフトの標準の出力)を報告するのが一般的です。人数が多いほど、2つの差は小さくなります。どちらを使ったかを明記しておくと確実です。
Q: 散布度が大きいのは、悪いことなのですか?
A: よい悪いではありません。散らばりは、個人差という研究したい情報そのものでもあります。逆に、全員がほぼ同じ値だと(範囲の制限)、ほかの変数との相関が見えにくくなります。
理解度を確認する問題
問題1. 5人の得点が3, 5, 7, 9, 11点であった。偏差の2乗和をnで割った分散として、正しいものはどれか。
- A. 約2.83
- B. 8
- C. 10
- D. 40
正解:B 平均は7、偏差は−4, −2, 0, 2, 4で、2乗和は16+4+0+4+16=40です。nで割ると40÷5=8になります。Dは2乗和そのもの、Cはn−1で割った不偏分散、Aは8の平方根の標準偏差です。
問題2. 平均50、標準偏差10の検査得点を、全員について2倍してから5を足した。変換後の平均・標準偏差・分散の組み合わせとして、正しいものはどれか。
- A. 平均105、標準偏差20、分散400
- B. 平均105、標準偏差25、分散625
- C. 平均105、標準偏差20、分散200
- D. 平均100、標準偏差20、分散400
正解:A 平均は50×2+5=105です。5を足しても全員が同じだけ動くので散らばりは変わらず、標準偏差は2倍の20、分散は20²=400(元の100の4倍)です。Bは標準偏差にも5を足した誤り、Cは分散を2倍しただけの誤り(2²=4倍が正しい)、Dは平均に5を足し忘れた誤りです。
問題3. 散布図とピアソンの積率相関係数に関する記述として、最も適切なものはどれか。
- A. 相関係数が0であれば、2変数の間にはどのような関係もない。
- B. 入学試験の合格者だけを対象に、試験の得点と入学後の成績の相関を求めると、受験者全体で求めた場合より相関が低くなりやすい。
- C. 一方の変数の単位をcmからmに変えると、相関係数の値も100分の1になる。
- D. 平均・分散・相関係数がすべて等しい2つのデータセットは、散布図も同じ形になる。
正解:B 合格者だけでは得点の範囲がせまくなり、相関が弱く見えやすくなります(範囲の制限、選抜効果)。Aは誤りで、r=0は直線的な関係がないことを示すだけで、曲線的な関係はありえます。Cは誤りで、相関係数は単位に左右されません。Dは誤りで、アンスコムの例がまさにその反例です。
関連キーワード
- 代表値(Measures of Central Tendency)
- 標準得点(Standard Score)/偏差値
- 相関係数(Correlation Coefficient)
- 外れ値(Outlier)
- 箱ひげ図(Box Plot)
- 確率分布(Probability Distribution)
- 連続量(Continuous Variable)
- 個人差(Individual Differences)
関連論文
まずこの1本
Anscombe, F. J.(1973)Graphs in statistical analysis. The American Statistician, 27(1), 17–21.
計算結果だけでなくグラフを見る大切さを、4組のデータ(アンスコムの例)で示した5ページの論文です。試験対策としては、平均・分散・相関係数が同じでも散布図は違いうること、外れ値や曲線的な関係は相関係数だけでは見抜けないこと、を押さえましょう。
https://doi.org/10.1080/00031305.1973.10478966その他の参考文献
Friendly, M., & Denis, D.(2005)“The early origins and development of the scatterplot.” Journal of the History of the Behavioral Sciences, 41(2), 103–130.
概要 散布図の誕生と発展の歴史をたどった論文です。散布図を統計グラフでもとくに用途の広い発明と位置づけています。
https://doi.org/10.1002/jhbs.20078ほそめがねのひとこと
分散と不偏分散の区別は、検定の勉強でまぎらわしかったですか? どこがですか?
覚え方
①計算の順番:「引いて・2乗・平均・ルート」。平均を引く(偏差)→2乗→平均すると分散→ルートで標準偏差。どこで止めたかで答えが変わります。
②n−1:「推定は1つ引いて控えめに割る」。母集団の推定ではn−1で割り、小さめに出るのを補います。
③外れ値に強いのは「箱の中」。四分位範囲は箱ひげ図の箱の長さです。ひげの先(範囲)は外れ値に振り回されます。
④散布図:「数字の前に、まず点を打て」。アンスコムの例は、数字は双子でも顔は別人です。
コメント