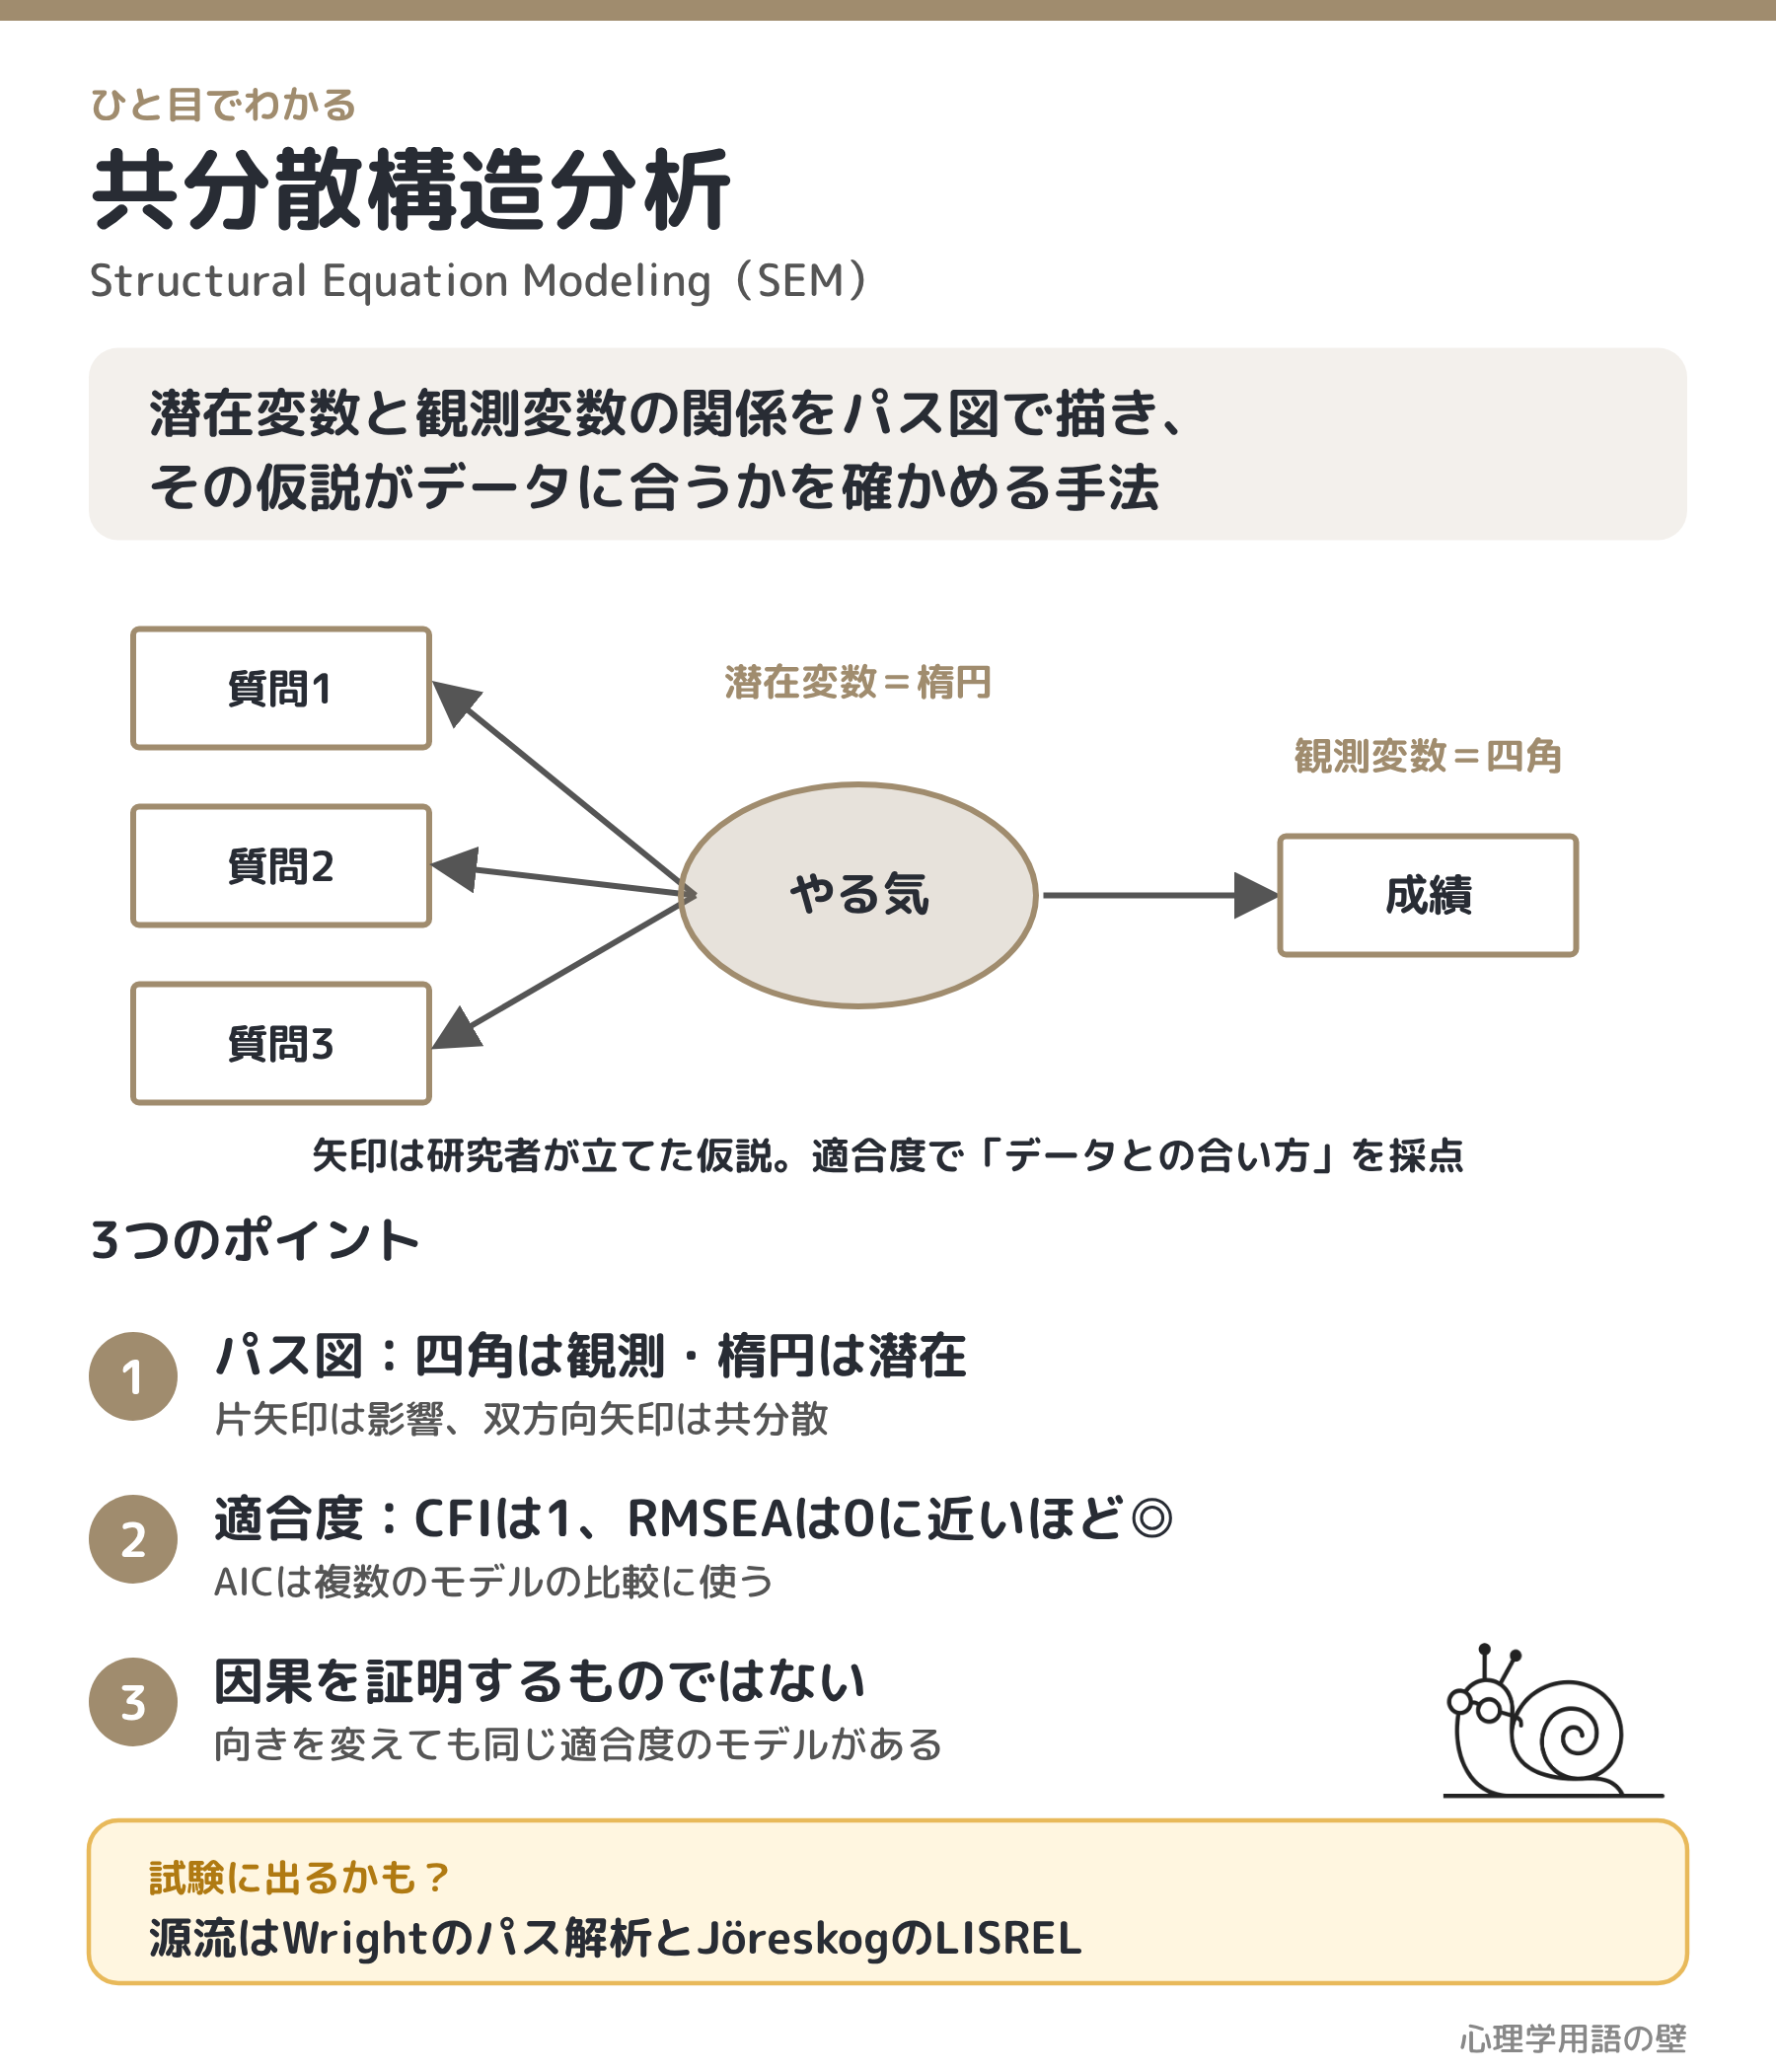
共分散構造分析(構造方程式モデリング:Structural Equation Modeling, SEM)とは、直接は測れない潜在変数と、実際に測った観測変数の関係を「パス図」で仮説として描き、その仮説がデータとどれくらい合っているかを確かめる統計手法です。
試験では、パス図の記号、適合度指標の読み方(1に近いほどよいか、0に近いほどよいか)、そして因果の証明にはならない点がよく問われます。
簡単な説明
「勉強へのやる気が高い人ほど成績がよい」と考えたとします。でも「やる気」は身長のように物差しでは測れません。そこで「自分から勉強する」「難しい問題にも挑戦する」などの質問を用意し、答えの背後に「やる気」が隠れていると考えます。
この考えを矢印つきの図(パス図)にし、「やる気→質問の答え」「やる気→成績」のように矢印を引きます。図が正しいなら、質問どうしや成績との間にどんな関連(いっしょに高くなったり低くなったりする度合い=共分散)が出るはずかを計算し、実際のデータとどれくらい一致するかを数値(適合度)で調べます。いわば「自分で描いた設計図が現実とどれだけ合っているか」の採点です。
由来
源流の1つは、遺伝学者 Sewall Wright のパス解析です。Wrightは1921年の論文「Correlation and causation」で、相関を経路(パス)ごとの効果に分ける方法を示し、1934年の「The method of path coefficients」で体系化しました。もう1つの源流が、潜在変数を扱う因子分析です。
この2つを結びつけたのが、スウェーデンの統計学者 Karl G. Jöreskog です。Jöreskogは1969年に確認的因子分析を最尤法で行う方法を、1970年に共分散構造の一般的な分析法を発表しました。さらに Dag Sörbom とともにソフトウェア LISREL(LInear Structural RELations:線形構造関係)を開発し、この手法が広まりました。日本語の「共分散構造分析」は covariance structure analysis の訳です。
具体的な説明
観測変数と潜在変数、測定方程式と構造方程式
質問項目の得点のように実際に測った変数が観測変数、やる気や知能のように観測変数の背後に仮定される構成概念が潜在変数です(→ 別記事「潜在変数」)。モデルは2つの部分からなります。
- 測定方程式(測定モデル):潜在変数が観測変数をどう生み出すか。矢印は潜在変数→観測変数の向きです。例:質問1の得点=因子負荷×やる気+誤差
- 構造方程式(構造モデル):変数どうしがどう影響し合うか。例:成績=係数×やる気+攪乱(説明しきれない部分)
測定方程式だけのモデルが確認的因子分析(CFA)、潜在変数を使わず観測変数だけで構造方程式を立てるのがパス解析です。共分散構造分析は、因子分析(→ 別記事「因子分析」)と重回帰分析・パス解析を1つにまとめた枠組みといえます。なお、因子の数や項目のまとまりをデータから探る探索的因子分析と違い、確認的因子分析は研究者が先に仮説を決めて検証します。
パス図の描き方
| 記号 | 意味 |
|---|---|
| 四角(長方形) | 観測変数 |
| 楕円(円) | 潜在変数 |
| 片方向の矢印 | 影響の向き(パス)。パス係数を添える |
| 双方向の矢印 | 共分散(相関)。因果の向きは仮定しない |
| 誤差・攪乱 | 内生変数に付く。観測変数には誤差(e)、潜在変数には攪乱(d) |
矢印を受けない変数を外生変数、1本でも受ける変数を内生変数といいます。内生変数には必ず誤差(攪乱)が付きます。
「ストレス→睡眠の質→抑うつ」のように間に入る変数を媒介変数といいます。経路をたどる間接効果はパス係数の積で、総合効果=直接効果+間接効果です。
しくみと識別性
モデルが正しければ、観測変数の分散・共分散はパラメータ(係数や分散)で表せます。モデルから導かれる共分散行列とデータの共分散行列のずれが最小になるようパラメータを推定します(代表的なのは最尤法)。分析の材料が個々のデータではなく共分散なので「共分散構造分析」と呼ばれます。
パラメータが1つに決まることを識別といいます。観測変数が p 個なら、手がかりになる分散・共分散は p(p+1)/2 個です。推定するパラメータ数がこれを超えると解が決まりません(識別不能)。その差が自由度で、自由度0のモデルは必ずデータに完全に合うため適合度を検定できません。また潜在変数には単位がないので、負荷の1つを1に固定するか分散を1に固定するなどして尺度を決めます。
適合度指標
| 指標 | 読み方 |
|---|---|
| χ²(カイ2乗)検定 | 帰無仮説は「モデルはデータに合っている」。有意にならないほうがよい。標本が大きいと小さなずれでも有意になりやすい |
| GFI/AGFI | 1に近いほどよい。AGFIは自由度で調整した値で、GFI以下になる |
| CFI(Bentler, 1990)/TLI | 変数間に関連がないモデル(独立モデル)と比べた改善度。1に近いほどよい |
| RMSEA(Steiger, 1990) | 自由度あたりのずれ。0に近いほどよい |
| SRMR | データとモデルの相関のずれ(残差)。0に近いほどよい |
| AIC(Akaike, 1974) | 複数のモデルを比べ、小さいほうがよい。1つのモデルの良し悪しの絶対基準ではない |
目安は Hu & Bentler(1999)の「CFI・TLIは.95前後以上、SRMRは.08前後以下、RMSEAは.06前後以下」がよく引用されます。ただし機械的な合格ラインではなく、複数の指標をあわせて判断します。
因果を証明するものではない
矢印は研究者が仮定した向きにすぎません。矢印の向きを変えてもまったく同じ適合度になるモデル(同値モデル)があります(MacCallum et al., 1993)。適合度がよいことは「データと矛盾しない」ことを示すだけで、因果の主張には研究デザインや理論の裏づけが必要です。
例文
「質問紙の5項目が『自尊感情』という1つの因子で説明できるかを、共分散構造分析による確認的因子分析で検討しました。」
「ストレスが睡眠の質を通して抑うつに影響するというパス図を描き、CFIやRMSEAで適合度を確かめました。」
疑問
Q: 「共分散構造分析」と「構造方程式モデリング」は別の手法ですか?
A: 同じ手法です。共分散を手がかりにするしくみに注目したのが前者、方程式でモデルを組み立てる点に注目したのが後者の呼び方です。
Q: χ²検定が有意になったら、モデルは捨てるべきですか?
A: すぐには捨てません。χ²値は標本が大きいほど大きくなり、実用上は問題のない小さなずれでも有意になりがちです。CFIやRMSEAなどもあわせて判断します。
Q: 適合度がよいモデルが見つかれば、それが正解のモデルですか?
A: そうとは限りません。まったく同じ適合度を示す別のモデル(同値モデル)もありえます。理論的なもっともらしさもあわせて考えましょう。
理解度を確認する問題
問題1. 共分散構造分析のパス図の表記として、最も適切なものはどれか。
- A. 観測変数は楕円、潜在変数は四角で表す
- B. 双方向の矢印は、変数間の因果の向きが両方向であることを表す
- C. 他の変数から矢印を受ける内生変数には、誤差または攪乱を付ける
- D. 確認的因子分析では、矢印を観測変数から潜在変数に向けて引く
正解:C 内生変数には、モデルで説明しきれない部分として誤差(攪乱)が付きます。Aは逆で、観測変数が四角、潜在変数が楕円です。Bは誤りで、双方向の矢印は共分散(相関)を表し、因果の向きは仮定しません。Dは逆で、潜在変数(因子)が観測変数の得点を生み出すと考えるので、矢印は潜在変数→観測変数です。
問題2. 適合度指標に関する説明として、最も適切なものはどれか。
- A. χ²検定は標本が大きいほど有意になりにくいので、大標本では特に信頼できる
- B. RMSEAとSRMRは、1に近いほど適合がよい
- C. AICは複数のモデルを比較するときに用い、値が小さいモデルを選ぶ
- D. AGFIは自由度で調整するため、GFIより大きい値になる
正解:C AICはモデル比較のための指標で、小さいほうがよいモデルです。Aは逆で、χ²値は標本が大きいほど大きくなり、小さなずれでも有意になりやすいのが弱点です。Bは誤りで、どちらもずれの大きさなので0に近いほどよい指標です。Dは誤りで、調整によって値はGFI以下になります。
問題3. 共分散構造分析に関する説明として、最も適切なものはどれか。
- A. 適合度が十分によいモデルが得られれば、変数間の因果関係が証明されたことになる
- B. 確認的因子分析は、構造方程式を含まず測定方程式だけからなるモデルとみなせる
- C. 観測変数が4個、推定するパラメータが10個のモデルは、自由度が正なので適合度を検定できる
- D. 探索的因子分析は、どの項目がどの因子に負荷するかを研究者が先に決めて検証する方法である
正解:B 確認的因子分析は、潜在変数と観測変数の関係(測定モデル)だけを扱います。Aは誤りで、矢印の向きが違っても同じ適合度になる同値モデルがあるため、因果の証明にはなりません。Cは誤りで、分散・共分散は4×5÷2=10個なので自由度は0です。必ず完全に適合するので、適合度を検定できません。Dは確認的因子分析の説明です。探索的因子分析は、因子の数や項目のまとまりをデータから探ります。
関連キーワード
- 確認的因子分析(Confirmatory Factor Analysis)
- パス解析(Path Analysis)
- 因果モデル(Causal Models)
- 重回帰分析(Multiple Regression Analysis)
- 適合度指標(Fit Indices)
- 同値モデル(Equivalent Models)
関連論文
まずこの1本
Hu, L., & Bentler, P. M.(1999)Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling, 6(1), 1–55.
シミュレーションで適合度指標の目安を検討した論文です。最尤法を前提に本文の目安(CFI・TLI .95、SRMR .08、RMSEA .06前後)を示し、SRMRとほかの指標を組み合わせた報告を勧めました。試験対策としては、指標ごとに「1に近いほどよい」か「0に近いほどよい」かと、χ²検定は大標本で有意になりやすいことを押さえましょう。
https://doi.org/10.1080/10705519909540118その他の参考文献
Jöreskog, K. G.(1970)“A general method for analysis of covariance structures.” Biometrika, 57(2), 239–251.
概要 観測変数の共分散行列を、パラメータで表したモデルの構造として分析する一般的な方法を示した論文です。
https://doi.org/10.1093/biomet/57.2.239ほそめがねのひとこと
パス図を初めて見たとき、四角と楕円の違いや矢印の意味をどう受けとめましたか?
覚え方
①パス図:「見える箱(四角)、見えない卵(楕円)」。測れる観測変数は箱、中身が見えない潜在変数は卵です。
②適合度:「FI(Fit Index=当てはまり)は1へ、R(Root=ずれの平方根)は0へ」。GFI・CFIは1に近いほど、RMSEA・SRMRは0に近いほどよい。χ²は「有意にならなくて一安心」、AICは「比べて小さいほうが勝ち」です。
③全体像:「因子分析+パス解析=SEM」。測定方程式(因子分析の部分)と構造方程式(パス解析の部分)の合体です。
コメント