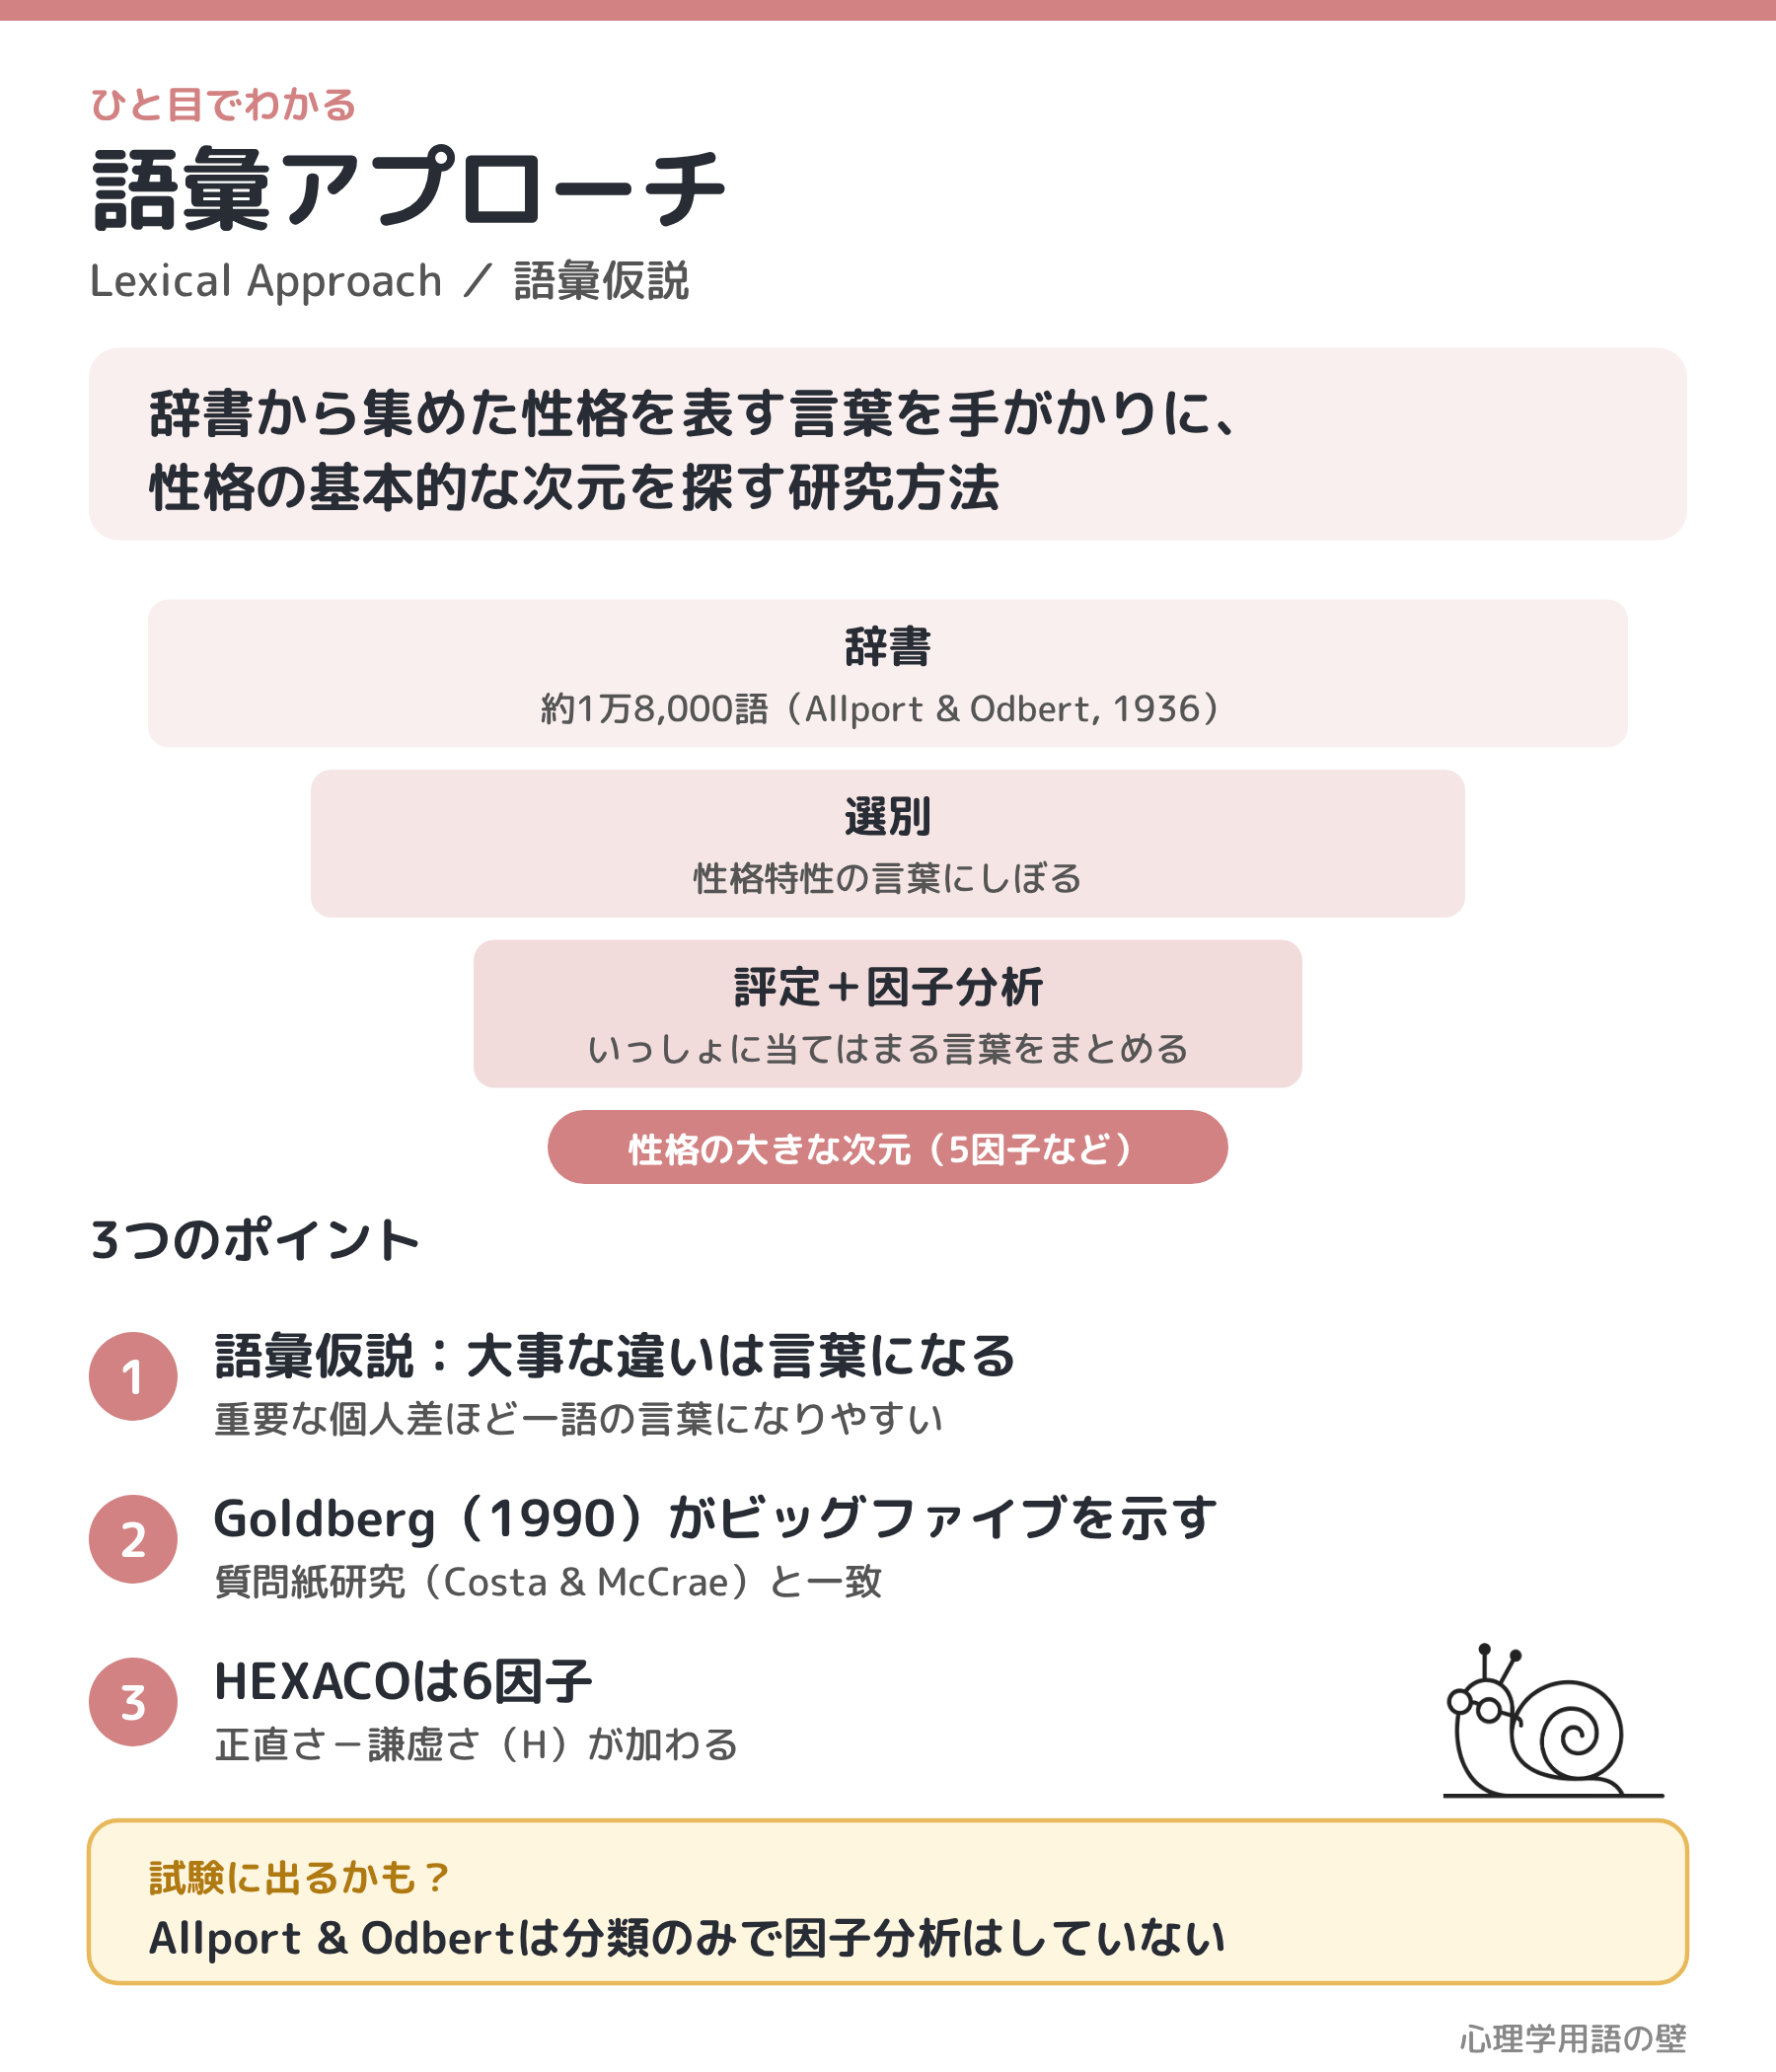
語彙アプローチ(Lexical Approach)とは、「人の性格の大事な違いは、ふだん使う言葉の中にすでに表れている」と考え、辞書から集めた性格を表す言葉を手がかりに、性格の基本的な次元を探す研究方法です。その土台となる考え方を語彙仮説(lexical hypothesis)といいます。
簡単な説明
友だちを紹介するとき、「明るい」「まじめ」「やさしい」「心配性」など、たくさんの言葉を使いますね。こうした言葉は、人を見分けるのに役立つからこそ残ってきたと考えられます。
辞書から性格の言葉を集め、多くの人に自分や知り合いを評定してもらうと、「明るい」「話し好き」「にぎやか」のように同じ人にいっしょに当てはまりやすい言葉がまとまります。服を引き出しに分けるように言葉を少数のグループに整理し、それを性格の大きな軸と考えるのです。
由来
| 年 | 主なできごと |
|---|---|
| 1884年 | Francis Galtonが「Measurement of Character」で類語辞典(Roget’s Thesaurus)から性格を表す言葉を約1,000語と見積もる |
| 1936年 | Gordon W. AllportとHenry S. Odbertが英語の大辞典から人を区別する言葉を約1万8,000語集め、4つの群に分類 |
| 1940年代 | Raymond B. Cattellが特性語の一覧を171の変数、さらに35のクラスターにしぼり、因子分析で十余りの因子を報告(のちの16PFへ) |
| 1949年・1961年 | Donald W. Fiske、Ernest C. TupesとRaymond E. ChristalがCattellの変数から5因子を見いだす |
| 1963年 | Warren T. Normanが仲間どうしの評定で5因子構造を再現 |
| 1990年 | Lewis R. Goldbergが論文「The Big-Five factor structure」で、約1,400語の形容詞などを使い5因子構造の一般性を示す |
| 2004年 | Michael C. AshtonとKibeom Leeらが7言語に共通する6因子構造を報告(HEXACOモデルへ) |
具体的な説明
語彙仮説の前提
語彙仮説は、「重要で目につきやすい個人差ほど、言語の中に言葉として刻まれていく」という仮定です。Saucier & Goldberg(2001)は、意味のある性格の特徴ほど一語の言葉になりやすい、という前提を語彙研究の根拠にあげています。ここから2つの方針が出てきます。
- 辞書は性格の「目録」になる:辞書の性格語は、話し手が重要とみなしてきた特徴の有限なリストになる
- 言語をこえて確かめる:重要な次元なら別の言語でも似た構造が現れるはずなので、多言語で研究がくり返された
言葉の分類:特性・状態・評価
Allport & Odbertは集めた言葉を4つの群に分けました。①性格特性(社交的な)、②一時的な状態・気分(おびえている)、③行いや人柄への評価(すばらしい)、④比喩的な言葉などその他です。「怒っている」(状態)と「怒りっぽい」(特性)の区別が要点です。なお、Allport & Odbertは言葉を集めて分類しただけで、因子分析はしていません。
特性論の方法であること
性格のとらえ方には、人をいくつかの型に分ける類型論(クレッチマーの体型論など)と、誰もが持つ特徴の程度の差で表す特性論があります。語彙アプローチで得られる因子は「外向性が高い・低い」のような連続的な次元なので、特性論に属します。
語彙アプローチと質問紙アプローチ
Paul T. CostaとRobert R. McCraeは、Cattellの16PFなど既存の質問紙の分析から出発し、のちにNEO-PI-Rを作りました。別々の出発点からほぼ同じ5次元にたどり着いたことが、5因子モデルが広まった理由の1つです。各因子の中身や測り方は「ビッグファイブ理論」の記事をご覧ください。
ビッグファイブとHEXACOの違い
| 項目 | ビッグファイブ | HEXACOモデル |
|---|---|---|
| 因子の数 | 5 | 6 |
| 独自の因子 | ― | 正直さ-謙虚さ(H) |
| 不安などの因子 | 神経症傾向(怒りっぽさも含む) | 情動性(E)。怒りっぽさは協調性の低い側へ |
日本語での研究
青木孝悦(1971)は国語辞典などから約6,000語を集めて分類しました。村上宣寛(2003)は大学生370名の評定データの因子分析から外向性・協調性・勤勉性・情緒安定性・知性の5因子を得ました。ただし細かな中身は英語圏と異なる可能性もあります。
批判と限界
- 変数選びの偏り:初期の5因子研究はCattellが選んだ変数に依存していた(Block, 1995)
- 言語による違い:12言語・14の分類体系を比べた研究では、言語をこえて完全に再現できたのは3因子まで(De Raad et al., 2010)
- 記述であって説明ではない:「性格をどう言い表すか」の構造で、原因までは示さない
実験や観察の方法と結論
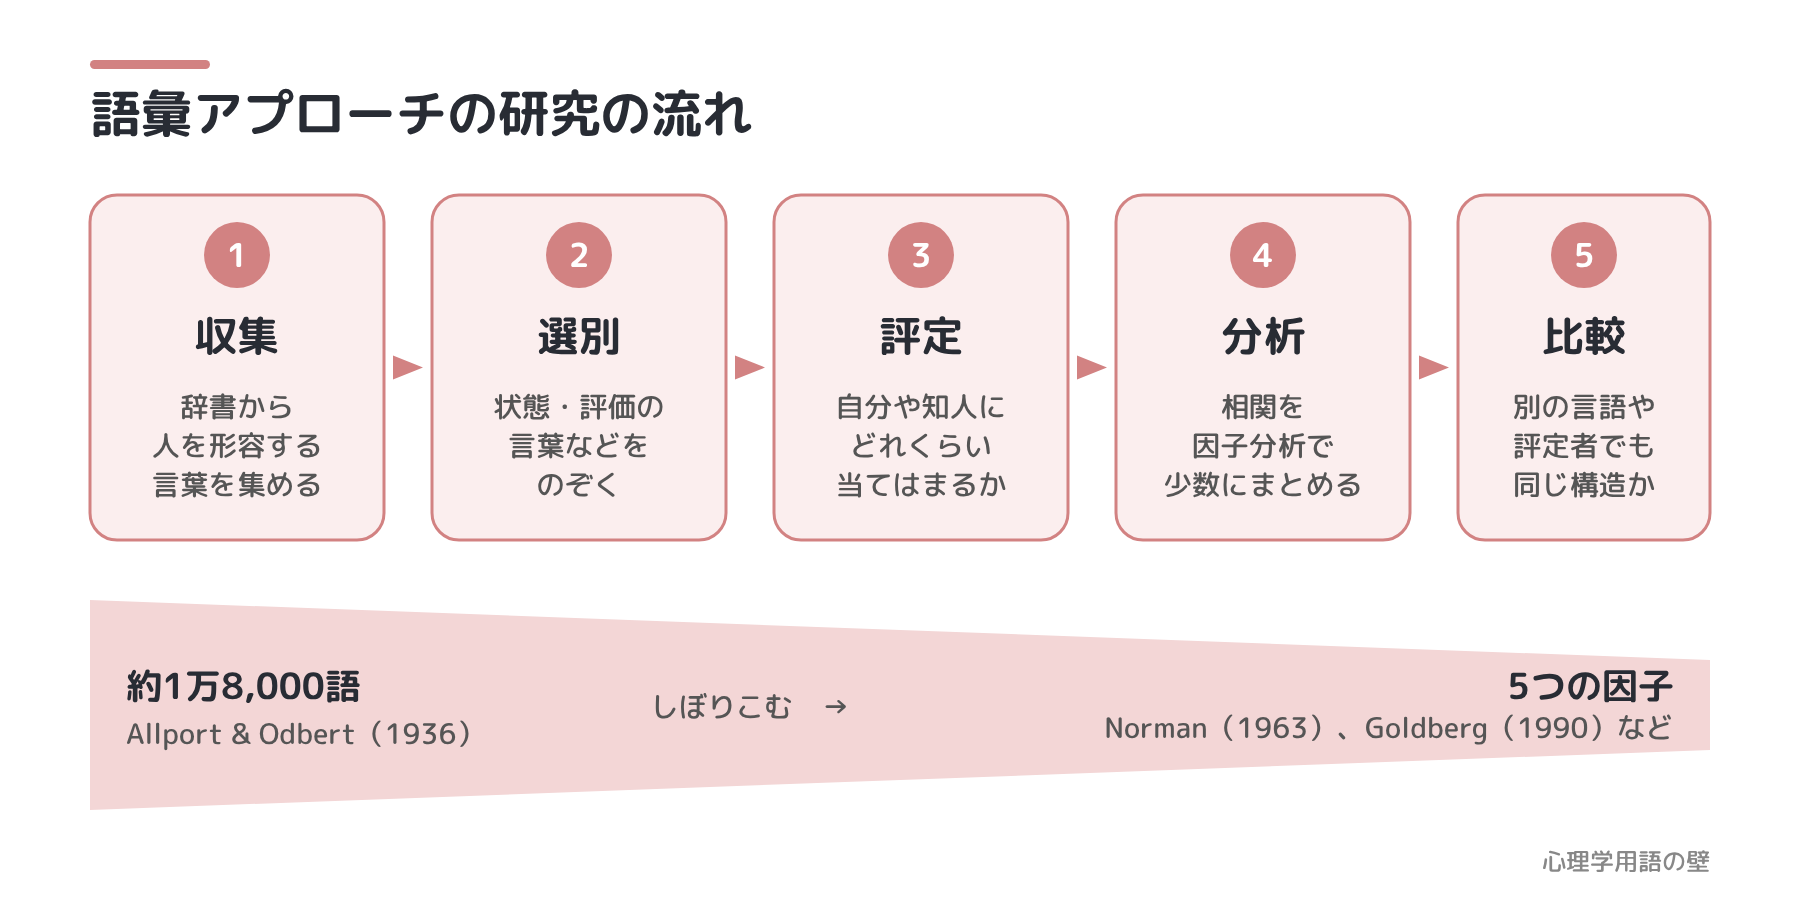
- ①収集:辞書から人を形容する言葉を抜き出す
- ②選別:状態・評価の言葉やなじみの薄い言葉をのぞく
- ③評定:自分や知人が各語にどれくらい当てはまるかを評定してもらう
- ④分析:相関を因子分析で少数の因子にまとめる
- ⑤比較:別の言語や評定者(自己・他者)でも同じ構造が出るか確かめる
結論:英語ではNorman(1963)やGoldberg(1990)などで5因子がくり返し得られ、日本語でも得られています(村上, 2003)。一方、Ashtonらはオランダ語・韓国語・ポーランド語など7言語の研究で、5因子に近い次元に正直さ-謙虚さ(Honesty-Humility)を加えた6因子が共通して現れると報告しました。
例文
「語彙アプローチでは辞書の性格語を出発点にするため、研究者の理論より先に、話し手が重視してきた特徴が分析の材料になります。」
「村上(2003)は日本語の性格語からも、語彙アプローチで5因子が得られることを示しました。」
疑問
Q: 語彙アプローチとビッグファイブは同じものですか?
A: 違います。語彙アプローチは性格の次元を探す方法で、ビッグファイブはその方法などで得られた結果(モデル)です。語彙アプローチから6因子が得られることもあります。
Q: 名前の似ている「語彙判断課題」と関係がありますか?
A: 直接の関係はありません。語彙判断課題は、文字列が単語かどうかを判断させて反応時間を測る認知心理学の課題です。どちらも「lexical」を使うので取り違えに注意しましょう。
Q: 言葉になっていない性格の特徴は、とらえられないのですか?
A: その可能性は限界として指摘されています。気づきにくい心の働きは言葉に残りにくいためです。結果は性格の説明ではなく記述の枠組みとして使うのが適切です。
理解度を確認する問題
問題1. 語彙仮説(lexical hypothesis)の前提として、最も適切なものはどれか。
- A. 性格を表す言葉が多い言語の話し手ほど、性格の個人差が大きい
- B. 重要で目につきやすい個人差ほど、日常の言語に一語の言葉として表れやすい
- C. 性格の基本次元は、どの言語から出発しても必ず同じ5つになる
- D. 辞書の性格語は、1語ずつが互いに独立した別々の特性に対応している
正解:B 重要な個人差ほど言葉に刻まれる、というのが語彙仮説の中心です。Aの「言葉の数=個人差の大きさ」は主張していません。Cは前提ではなく確かめる対象で、実際には6因子が出る言語もあります。Dは逆で、似た意味の言葉がまとまることを因子分析で利用します。
問題2. Allport & Odbert(1936)の研究に関する説明として、最も適切なものはどれか。
- A. 類語辞典を調べ、性格を表す言葉が約1,000語あると見積もった
- B. 特性語をしぼり込んで因子分析し、のちの16PFにつながる因子を報告した
- C. 英語の辞書から人を区別する言葉を約1万8,000語集め、特性・状態・評価などに分類した
- D. 辞書の性格語を因子分析し、5因子構造を初めて報告した
正解:C Allport & Odbertの業績は、辞書からの言葉の収集と分類で、因子分析はしていません。AはGalton(1884)、BはCattellの説明です。Dの5因子はFiske(1949)やTupes & Christal(1961)がCattellの変数から見いだしたものです。人名と業績の組み合わせは試験で問われやすい点です。
問題3. 語彙アプローチとその展開に関する説明として、最も適切なものはどれか。
- A. 語彙アプローチで得られる因子は、人をいくつかの型に分ける類型論の枠組みである
- B. 複数の言語の語彙研究から、正直さ-謙虚さを含む6因子構造が報告されている
- C. Ashtonらの6因子構造では、怒りっぽさは情動性(Emotionality)の因子に含まれる
- D. 語彙研究の結果は、性格の個人差が生じる原因を説明する理論である
正解:B Ashtonらが7言語から6因子構造を報告し、HEXACOモデルにつながりました。Aは誤りで、因子は程度の差を表す特性論の次元です。Cは誤りで、怒りや不機嫌は情動性ではなく協調性の低い側に入ります。Dは誤りで、語彙研究は記述の枠組みです。
関連キーワード
- ビッグファイブ理論(Big Five Theory)
- 因子分析(Factor Analysis)
- オールポートの性格理論(Allport’s Trait Theory)
- パーソナリティ理論(Personality Theory)
- 暗黙のパーソナリティ(Implicit Personality Theory)
- クレッチマーの体型論(Kretschmer’s Constitutional Types)
- 16PF(16 Personality Factor Questionnaire)
- HEXACOモデル(HEXACO Model)
関連論文
まずこの1本
Allport, G. W., & Odbert, H. S.(1936)Trait-names: A psycho-lexical study. Psychological Monographs, 47(1), i–171.
英語の大辞典から人の行動を区別する言葉を約1万8,000語集め、4つの群に分類した、語彙アプローチの出発点です。試験対策としては、約1万8,000語という規模、特性と状態の区別、因子分析はしていないこと、そしてGalton(言葉の数の見積もり)→Allport & Odbert(収集と分類)→Cattell(しぼり込みと因子分析)という順番を押さえましょう。
https://doi.org/10.1037/h0093360その他の参考文献
Saucier, G., & Goldberg, L. R.(2001)“Lexical studies of indigenous personality factors: Premises, products, and prospects.” Journal of Personality, 69(6), 847–879.
概要 語彙研究の前提を整理し、英語と12言語の因子構造を比べたレビューです。ビッグファイブの再現性は言語で異なるとしています。
https://doi.org/10.1111/1467-6494.696167ほそめがねのひとこと
自分の性格を3つの言葉で表すとしたら、どんな言葉を選びますか?その言葉は、自分で選んだものと人から言われたもの、どちらが多いでしょうか?
覚え方
①歴史の流れ:「千・万・十六・五・六」。千=Galton(約1,000語の見積もり)、万=Allport & Odbert(約1万8,000語)、十六=Cattell(16PFへ)、五=Fiske・Norman・Goldberg(5因子の発見と再現)、六=Ashtonら(6因子)。
②6つ目の因子:「H=Honesty(正直さ)」。HEXACOの頭のHが、語彙研究で加わった正直さ-謙虚さです。
コメント