t検定(t-test)とは、2つの平均値の差が偶然のばらつきで説明できる程度か、偶然とはいいにくい差かを調べる検定です。平均の差を平均のぶれの大きさで割ったt値を、t分布に照らして判断します。
簡単な説明
2つの勉強法で10点満点の小テストをしたとします。勉強法Aの5人は5・6・7・8・9点(平均7点)、勉強法Bの5人は3・4・5・6・7点(平均5点)でした。2点の差は勉強法のおかげでしょうか、それともたまたまでしょうか。
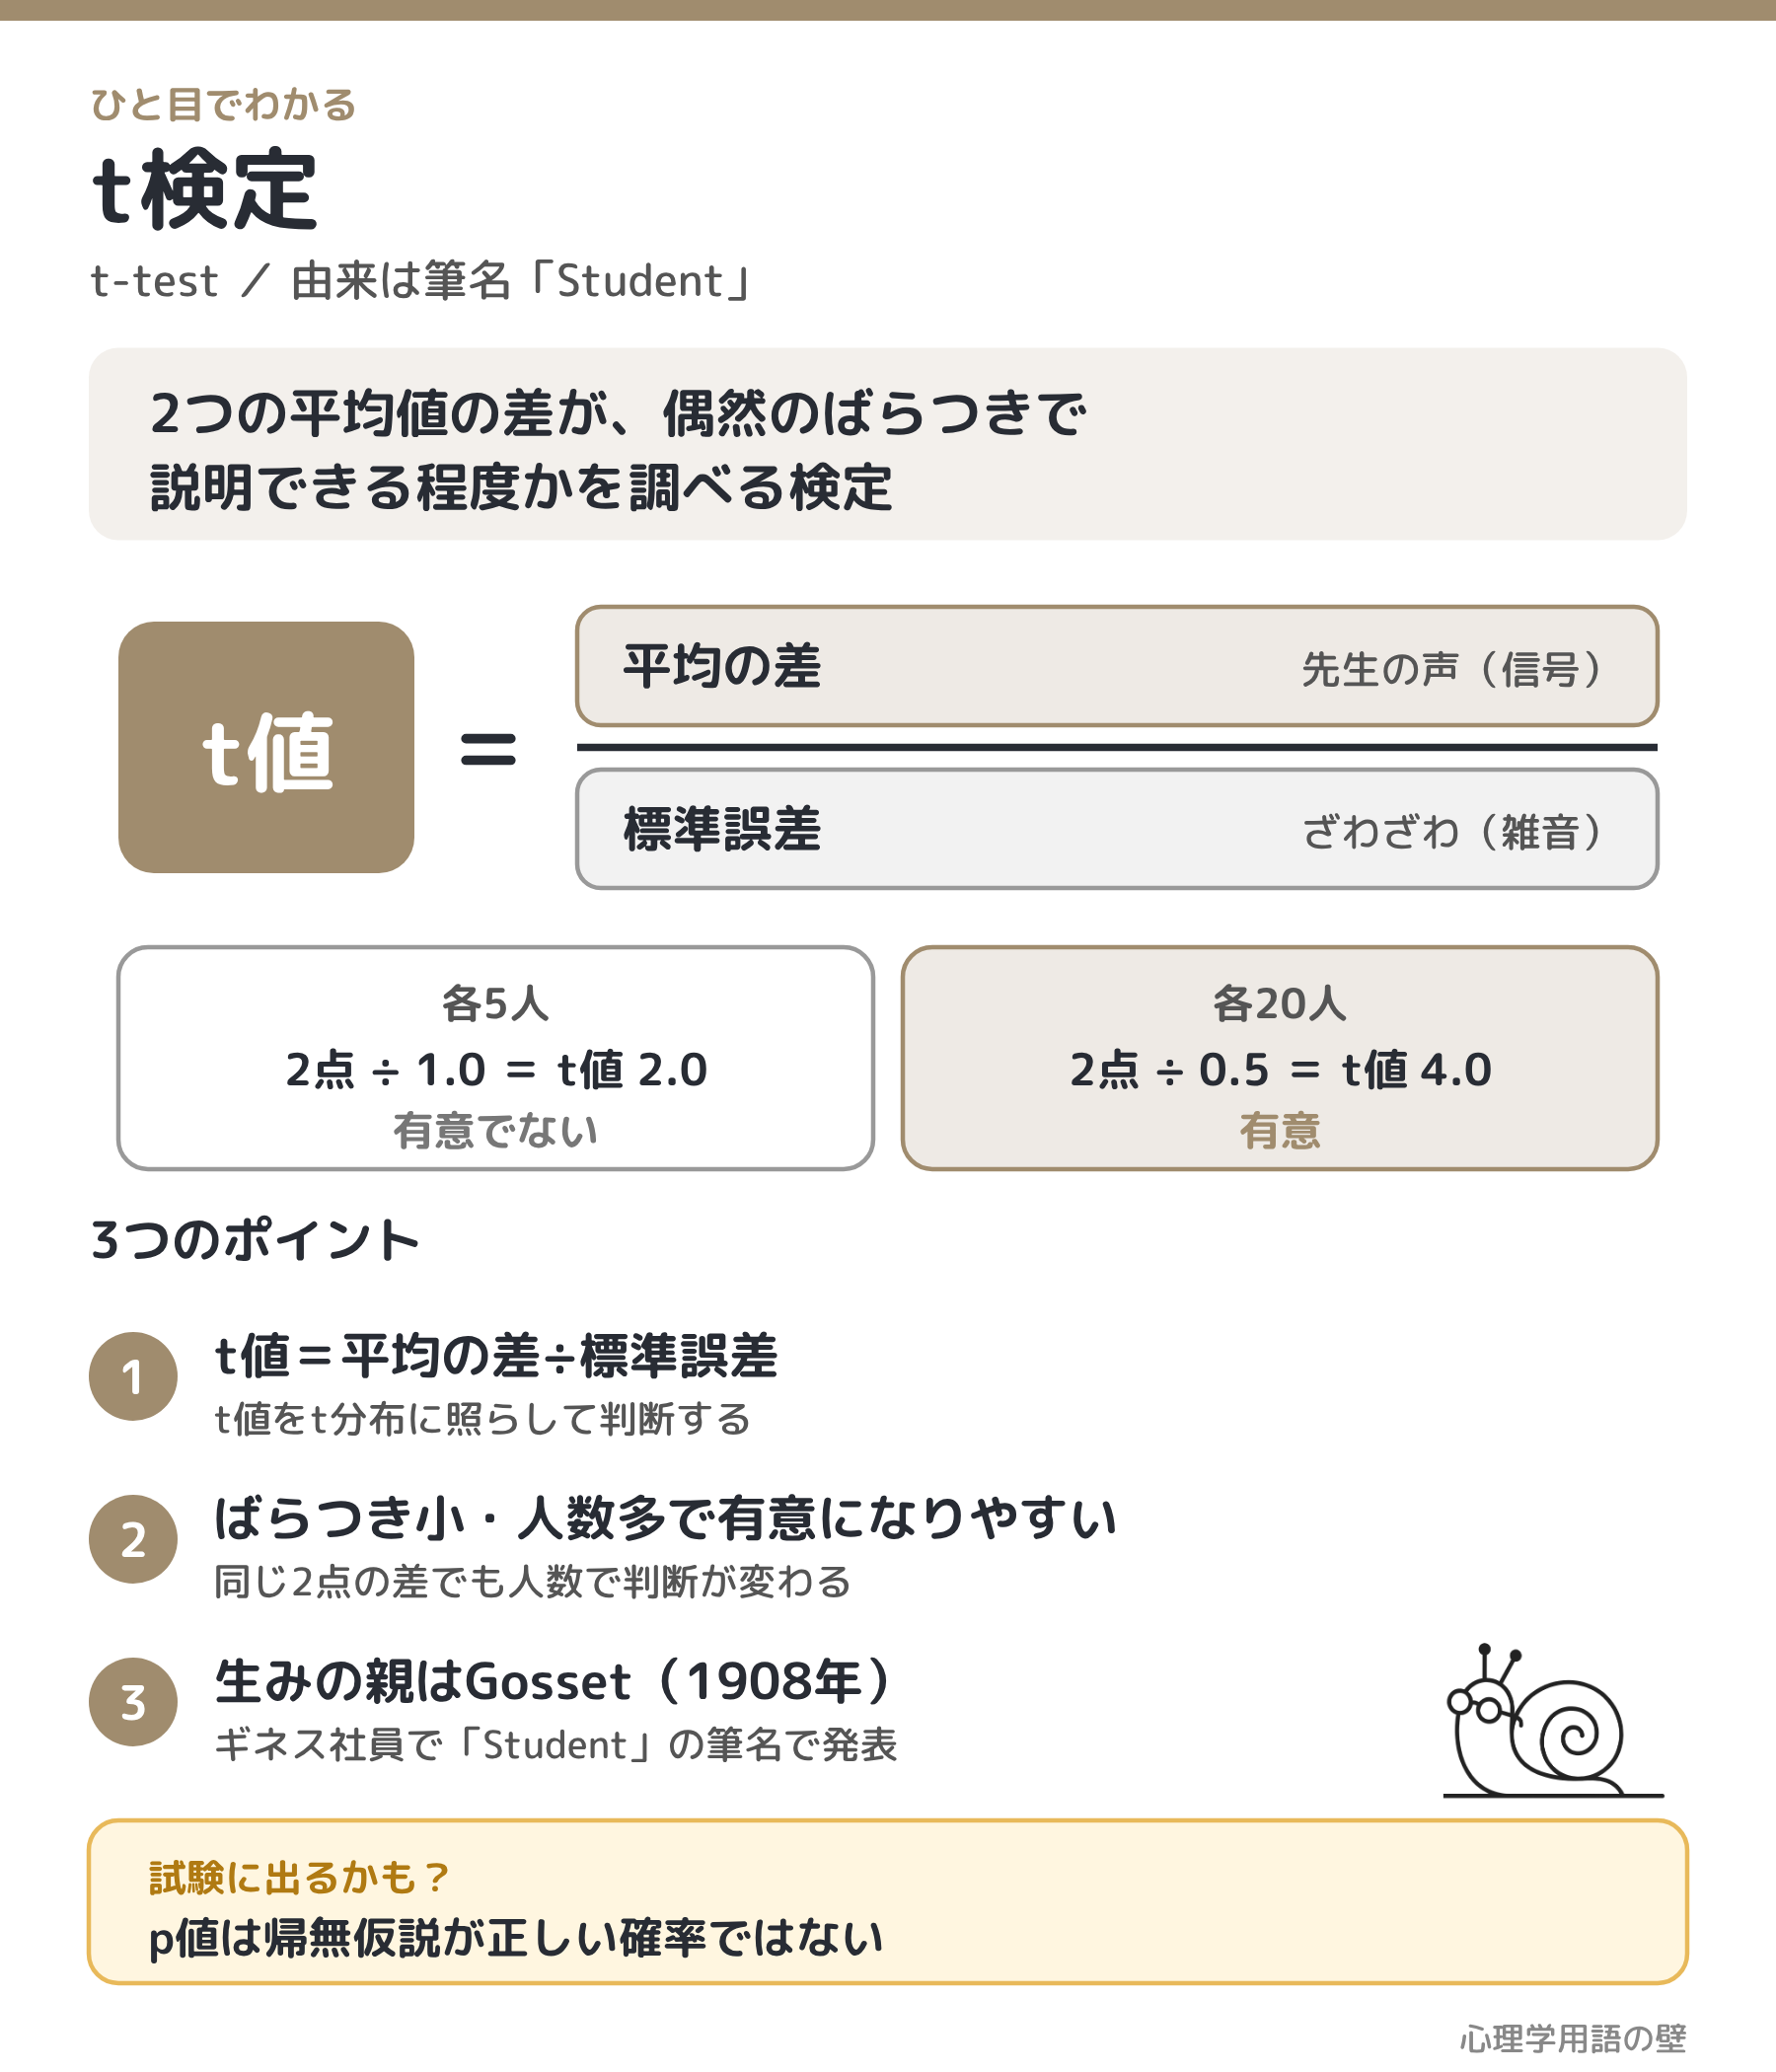
同じ勉強法でも点数はばらばらなので、別の5人で測り直せば平均は1〜2点ぶれそうです。ざわざわした教室(ばらつき=雑音)で先生の声(平均の差=信号)が聞こえるか、を数字にするのがt検定です。
t値 = 平均の差 ÷ 標準誤差(平均がどれくらいぶれるかの目安)
標準誤差は、ばらつき(標準偏差)が大きいほど大きく、人数が多いほど小さくなります。人数だけ変えると次のとおりです。
| 項目 | 各5人 | 各20人 |
|---|---|---|
| 平均の差 | 2点 | 2点 |
| 標準誤差 | 1.0 | 0.5 |
| t値 | 2.0 | 4.0 |
| 5%水準の境目(臨界値) | 約2.31 | 約2.02 |
| 判断 | 有意でない | 有意 |
同じ2点の差でも、ばらつきが小さいほど、人数が多いほど「偶然ではない」と判断しやすくなるのです。
由来
t検定のもとを作ったのは、イギリスの化学者・統計学者 William Sealy Gosset(1876〜1937)です。Gossetは1899年にダブリンのビール会社ギネスに入社し、醸造の試験のように少ない回数しかできない実験から結論を出す問題に取り組み、1906〜1907年にはロンドンで Karl Pearson のもとで研究しました。
その成果が、1908年に Biometrika 誌に載った「The probable error of a mean(平均の確率誤差)」です。勤務先の方針で本名は出せず、「Student」という筆名で発表しました。t分布を「スチューデントのt分布」と呼ぶのはこのためです。
なお、Gosset自身が使った統計量は z で、今の t の形に書きかえたのは Ronald A. Fisher(1925)です。
具体的な説明
検定の流れ
- 帰無仮説「2つの母平均は等しい(差は0)」と、その反対の対立仮説を立てます。
- 有意水準(α)を決めます。心理学では5%(.05)がよく使われます。
- 帰無仮説が正しいとき今回以上に極端なt値が出る確率(p値)を、t値と自由度から求めます。
- p<α なら帰無仮説を棄却し「有意差あり」とします。差がないのに棄却するのが第1種の誤り(確率はα)、差があるのに見逃すのが第2種の誤りです。
t分布は正規分布に似た山形ですが裾が厚く、形は自由度で決まります。自由度が小さいほど臨界値は大きく(両側5%で自由度9なら約2.26、100なら約1.98)、自由度が増えるほど正規分布の1.96に近づきます。
3つの種類と自由度
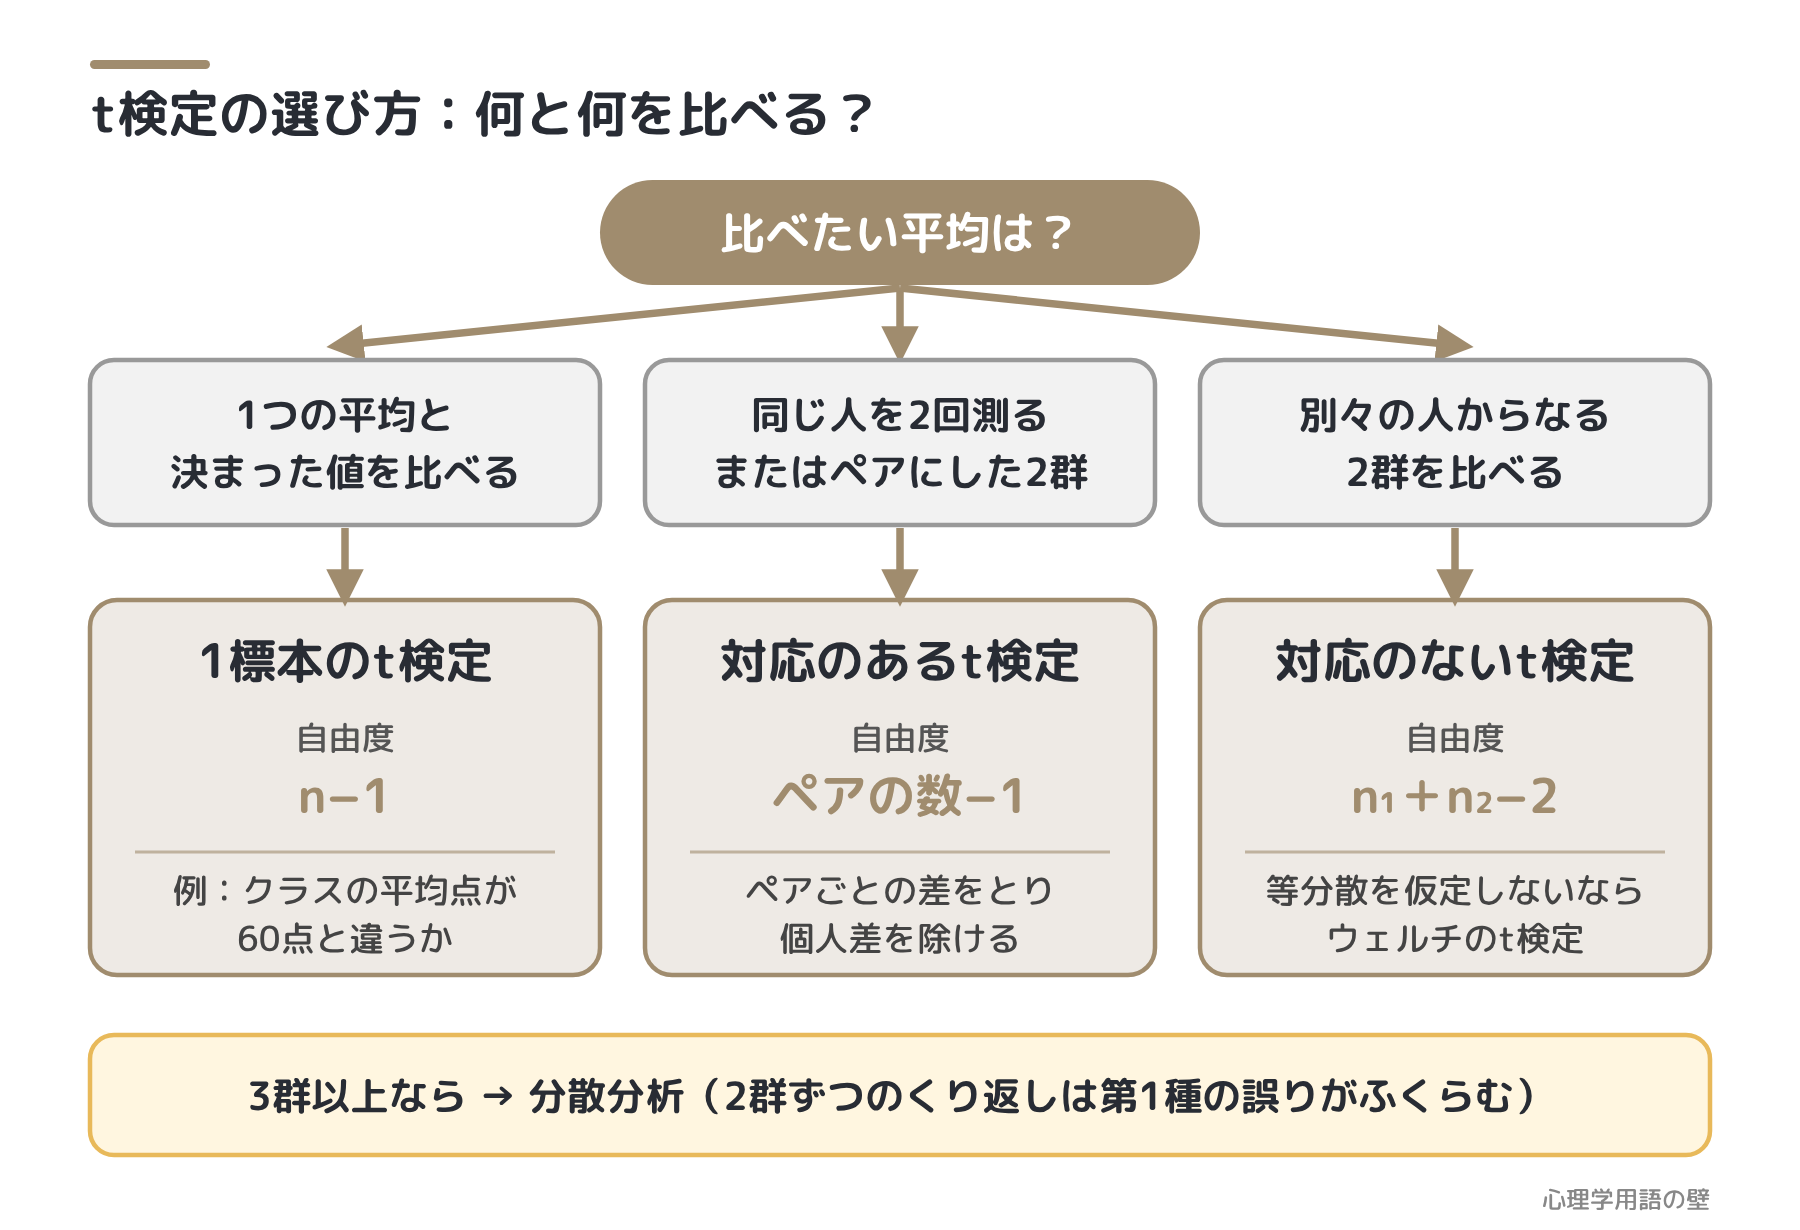
| 種類 | 使う場面 | 例 | 自由度 |
|---|---|---|---|
| 1標本のt検定 | 1つの平均を決まった値と比べる | クラスの平均点が60点と違うか | n−1 |
| 対応のないt検定 | 別々の人からなる2群を比べる | 勉強法Aの群とBの群 | n₁+n₂−2 |
| 対応のあるt検定 | 同じ人を2回測る、またはペアにした2群 | 同じ人の練習前と練習後 | ペアの数−1 |
対応のあるt検定は、ペアごとに「後−前」の差を出し、差の平均が0と違うかを1標本のt検定で調べるのと同じです。差の分散は「分散₁+分散₂−2×共分散」なので、2回の得点に正の相関がある(得意な人は2回とも高い)ほど個人差が打ち消され、差を見つけやすくなります。事前の得点が近い別々の人をペアにした場合(マッチング)も「対応あり」です。
前提とウェルチの検定
t検定はパラメトリック検定の代表で、正規性・独立性に加え、対応のないt検定では等分散性(2群の母分散が等しい)を前提にします。
等分散を仮定しないのがウェルチのt検定(Bernard L. Welch, 1947)で、自由度は補正されて n₁+n₂−2 以下になり、小数にもなります。等分散を仮定する方法は「スチューデントのt検定」と呼びます。
片側検定と両側検定
方向を問わず「違うか」を調べるのが両側検定、「AはBより大きいか」と方向を決めるのが片側検定です。片側は予想した方向では有意になりやすい(自由度9なら臨界値約1.83)代わりに、反対方向の差は検出できません。方向はデータを見る前に決めます。
効果量(Cohenのd)と結果の書き方
p値は人数で変わるので、差の大きさは平均の差を標準偏差で割ったCohenのdで示します。冒頭の例では d=2÷約1.58≒1.26 で、5人でも20人でも同じです。Jacob Cohen(1988)の目安は0.2が小、0.5が中、0.8が大ですが、機械的に当てはめないことが大切です(Lakens, 2013)。論文では「t(8) = 2.00, p = .081, d = 1.26」のように自由度・t値・p値・効果量をセットで書きます。
3群以上なら分散分析へ
3群以上で2群ずつt検定をくり返すと、第1種の誤りを犯す確率がふくらみます(多重比較の問題)。3群以上は分散分析で一度に調べるのが基本です。
実験や観察の方法と結論
Student(1908)は最初の例題に、Cushny と Peebles の睡眠薬のデータを使いました。患者10人で、2種類の薬による睡眠の増加時間を記録したものです。
Studentは「本当の論点は薬2が薬1より良いかだ」として、患者ごとに「薬2−薬1」の差をとって分析しました。差の平均は+1.58時間で、「薬2のほうが良い」ことのオッズを約666対1と計算し、差のばらつきが小さいのは同じ患者が2つの薬に似た反応をする(相関がある)ためだろうと述べています。これは今の対応のあるt検定の考え方そのもので、差の値を今日の方法で計算すると t(9)≒4.06、p≒.003 です。
ただし後に、薬の名前の取り違えや、各値が3〜6回の測定の平均であることが指摘されました(Zabell, 2008)。差をとると個人差を除けること、データは原典で確かめるべきことを教えてくれる例です。
例文
「同じ参加者に練習前と練習後のテストを行ったので、対応のないt検定ではなく、対応のあるt検定で平均の差を調べました。」
「2群の分散が異なっていたため、ウェルチのt検定を用い、効果量としてCohenのdも報告しました。」
疑問
Q: t検定で有意にならなければ、2つの平均には差がないといえますか?
A: いいえ、いえません。有意でないのは「偶然でも説明できる範囲だった」というだけです。人数が少ないと本当の差も見逃しやすくなります(第2種の誤り)。
Q: まず等分散の検定をして、その結果でスチューデントとウェルチを選べばよいですか?
A: 近年は勧められていません。Delacre, Lakens, & Leys(2017)は、等分散の検定(Levene の検定)は検定力が低いことが多いため二段階の手順は使うべきでないとし、最初からウェルチのt検定を使うよう勧めています。
Q: 対応のあるデータを、対応のないt検定で分析するとどうなりますか?
A: 2群が独立という前提に反するうえ、差をとれば消えるはずの個人差が雑音に残るため、多くの場合t値が小さくなり、本当の差を見逃しやすくなります。
理解度を確認する問題
問題1. 事前得点が近い2人ずつで10組のペアをつくり、各ペアの一方を新しい学習法、他方を従来の学習法に無作為に割り当てた。2つの学習法の平均を比べる方法として、最も適切なものはどれか。
- A. 対応のないt検定
- B. 対応のあるt検定
- C. ウェルチのt検定
- D. 一要因分散分析(対応なし)
正解:B 別々の人でも、ペアにして割り当てた(マッチング)データは1対1で結びついているので「対応あり」です。自由度はペアの数−1=9です。Aは「別の人だから対応なし」と考えるとひっかかる選択肢で、ペアの情報を捨てて検定力が下がります。Cは等分散を仮定しない対応のない2群の検定、Dも対応のない群の比較で、ペアの情報を使いません。
問題2. 実験群12名と統制群10名の平均を、等分散を仮定した対応のないt検定で比較した。このときの自由度として、正しいものはどれか。
- A. 9
- B. 11
- C. 20
- D. 21
正解:C 対応のないt検定の自由度は n₁+n₂−2 なので、12+10−2=20です。2群でそれぞれ平均を推定するので2を引きます。Dは全人数−1で、引くのが1つ足りません。AとBは1群だけの n−1 で、1標本や対応のあるt検定の考え方です。
問題3. t検定に関する説明として、最も適切なものはどれか。
- A. p<.05 であれば、帰無仮説が正しい確率は5%未満である
- B. 片側検定は、データを見て差が出た方向に設定すれば、検定力を高められる適切な方法である
- C. 平均の差と標準偏差が同じなら、人数が多いほどCohenのdは大きくなる
- D. 平均の差と標準偏差が同じなら、人数が多いほどt値は大きくなる
正解:D 人数が増えると標準誤差が小さくなるので、t値は大きく、p値は小さくなります。Cはまぎらわしいですが誤りで、dは平均の差÷標準偏差なので人数では変わりません。Aは誤りで、p値は帰無仮説が正しいと仮定したときに今回以上に極端な結果が出る確率で、仮説が正しい確率ではありません。Bは誤りで、データを見てから方向を決めると第1種の誤りが実質的にふくらみます。
関連キーワード
- パラメトリック検定/ノンパラメトリック検定(Parametric Test / Nonparametric Test)
- 分散分析(Analysis of Variance: ANOVA)
- 確率分布(Probability Distribution)
- 散布度/散布図(Measures of Dispersion / Scatter Plot)
- 帰無仮説(Null Hypothesis)
- 第1種の誤り/第2種の誤り(Type I Error / Type II Error)
- 効果量(Effect Size)
- 多重比較(Multiple Comparisons)
関連論文
まずこの1本
Student(1908)The probable error of a mean. Biometrika, 6(1), 1–25.
Gossetが「Student」の筆名で発表した、t検定の出発点となる論文です。標本が小さいと標準偏差の推定そのものがぶれ、正規分布の表をそのまま使うと判断を誤ることを指摘し、正規分布を仮定して小標本の平均の分布と数表を示しました。試験対策としては、Gosset=Student(筆名)、1908年・Biometrika、tの形にしたのはFisher、例題が今の対応のあるt検定にあたることを押さえましょう。
https://doi.org/10.2307/2331554その他の参考文献
Delacre, M., Lakens, D., & Leys, C.(2017)“Why psychologists should by default use Welch’s t-test instead of Student’s t-test.” International Review of Social Psychology, 30(1), 92–101.
概要 心理学では2群の分散が等しいとは限らないと論じ、等分散の検定で方法を選ぶ二段階の手順をやめて、ウェルチのt検定を標準にするよう勧めた論文です。分散が違うときに第1種の誤りをよりよく抑えられる点が理由です。
https://doi.org/10.5334/irsp.82ほそめがねのひとこと
t検定の「対応あり」と「対応なし」の見分けで迷ったことはありますか?
覚え方
①t値は「声 ÷ ざわざわ」。平均の差(声)を標準誤差(ざわざわ)で割ります。
②由来は「ビール工場の学生(Student)」。ギネスのGossetが1908年に発表しました。
③使い分けは「ペアなら差をとる、分散が違えばウェルチ、3つ以上は分散分析」。自由度は「対応ありはペア数−1、対応なしは n₁+n₂−2」です。
コメント