評定尺度法(Rating Scale Method)とは、人やものごと、自分の気持ちを「1 まったくあてはまらない〜5 とてもあてはまる」のような段階のある物差しで評価してもらい、数値で測る方法です。代表的なものにリッカート法とSD法があります。
簡単な説明
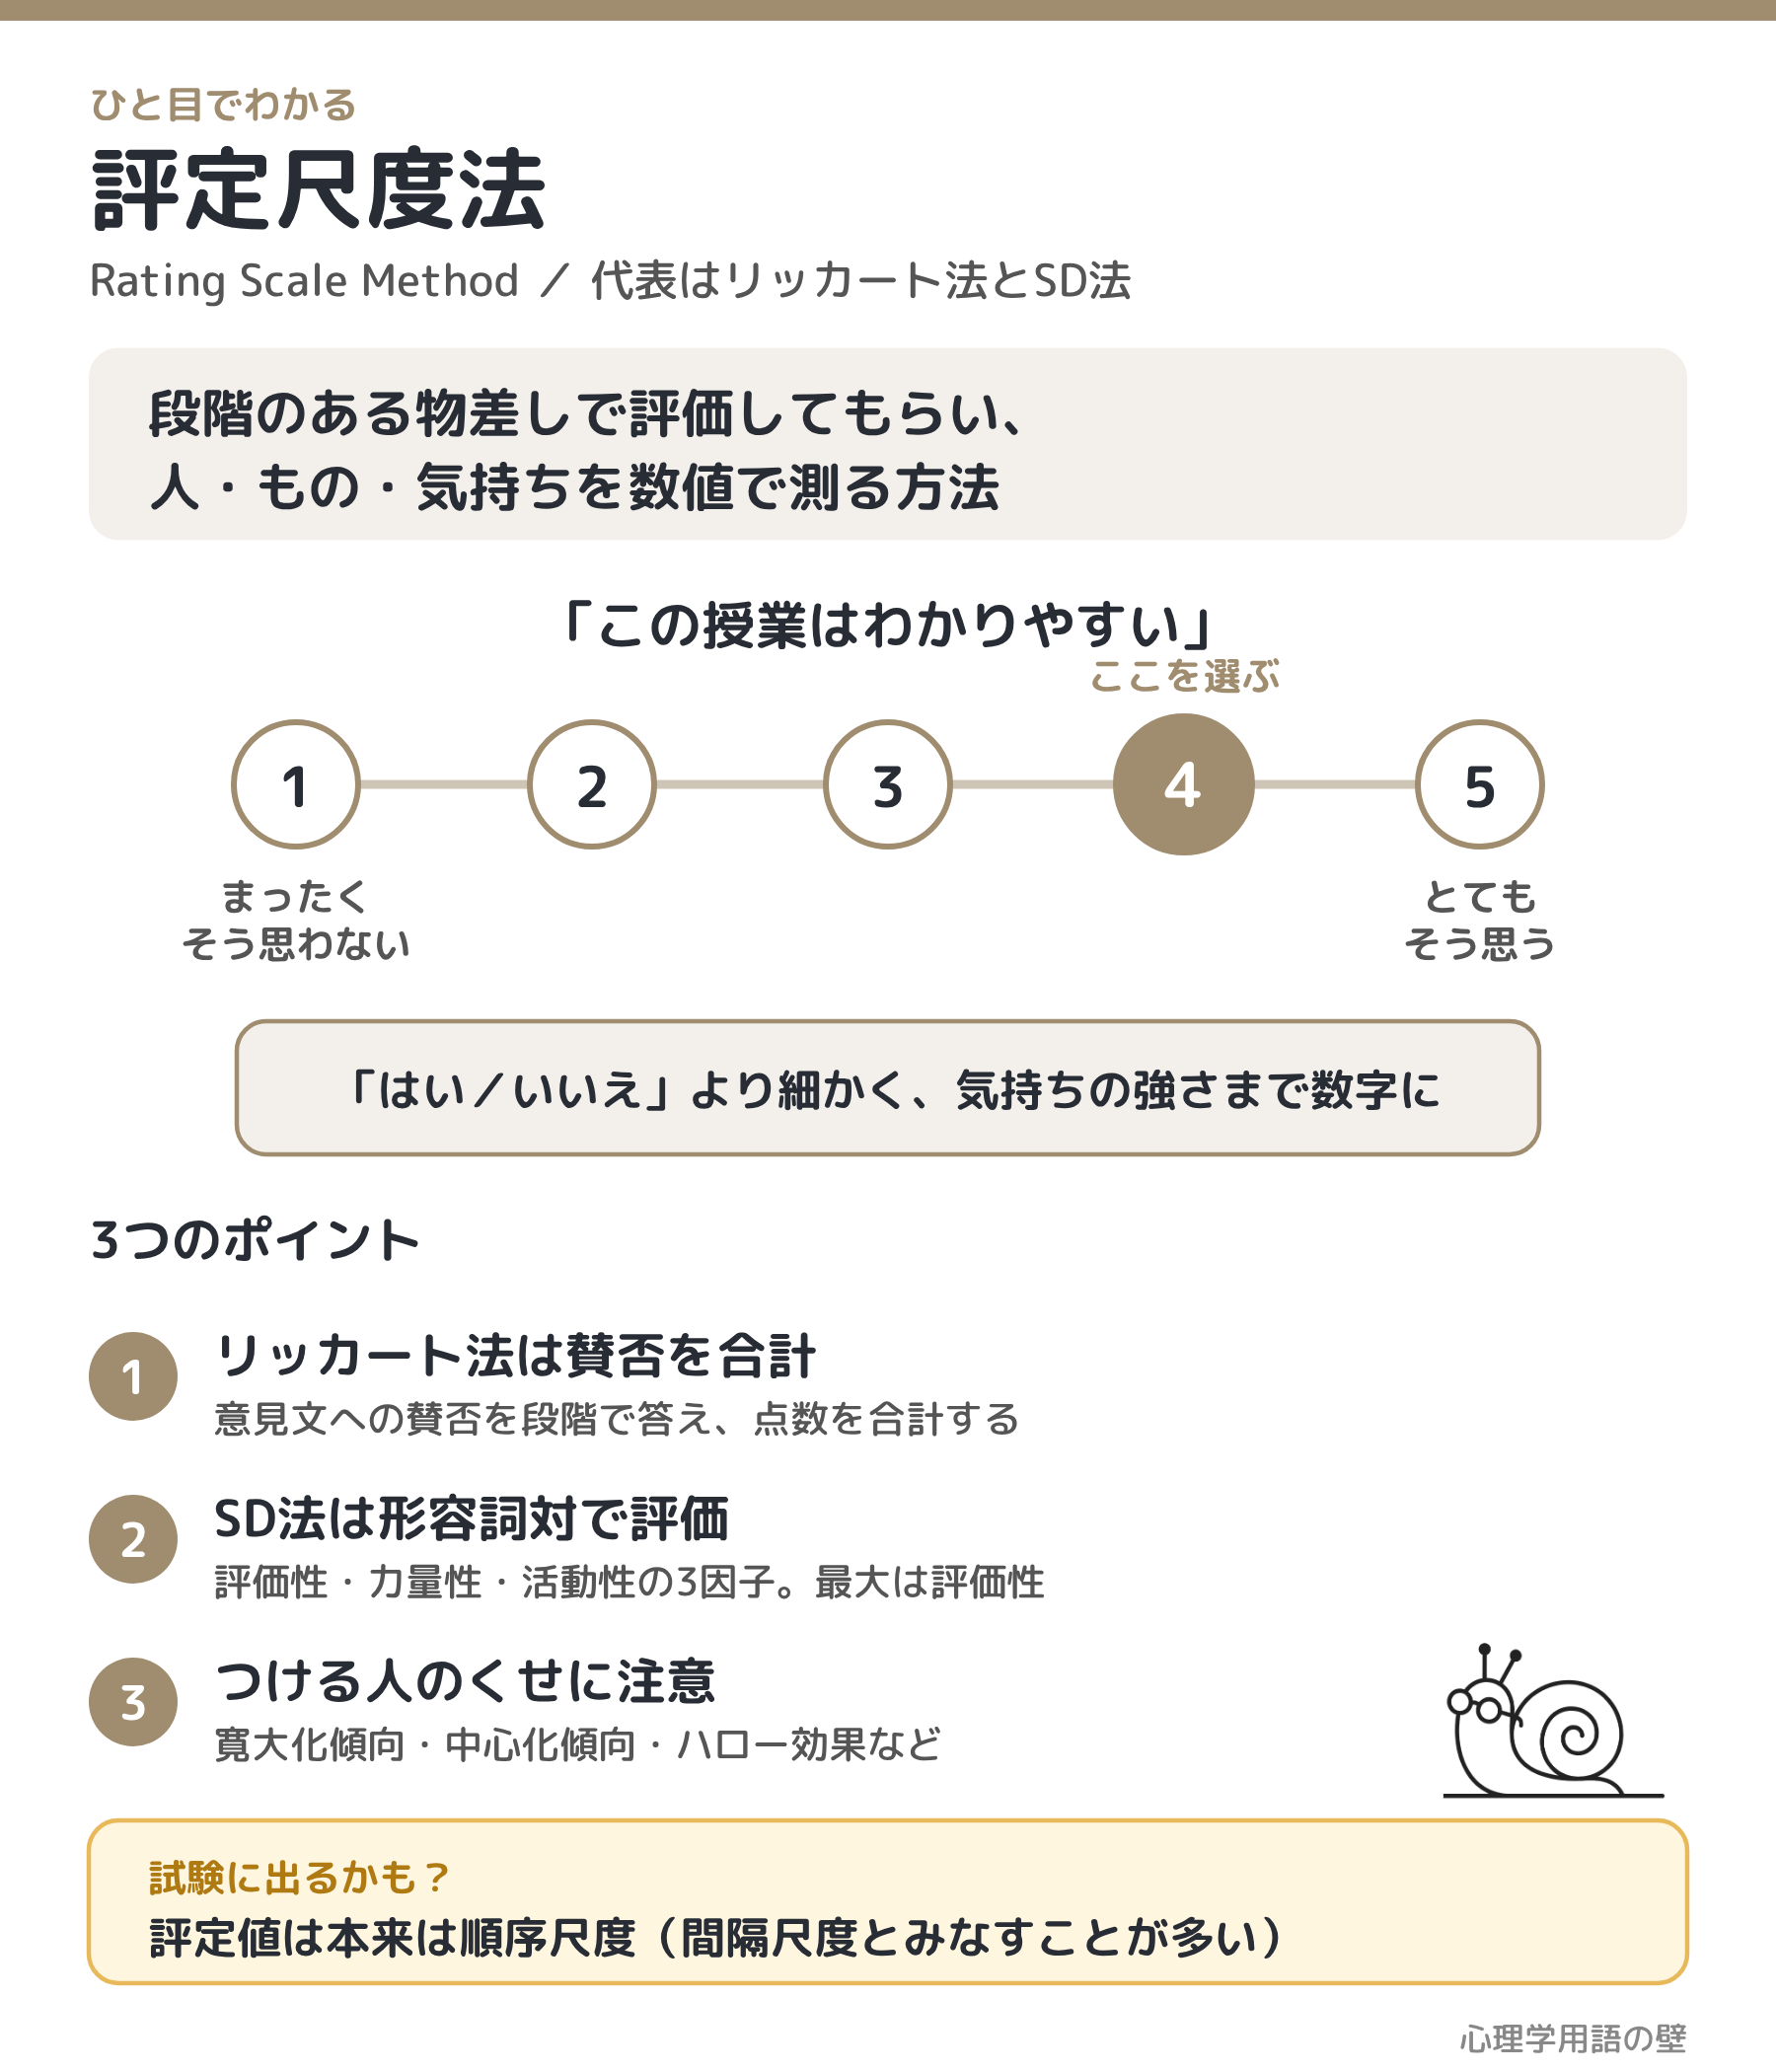
学校の授業アンケートで、「この授業はわかりやすい」に「5 とてもそう思う〜1 まったくそう思わない」から1つ選んだことはありませんか。これが評定尺度です。「はい/いいえ」より細かく、気持ちの強さまで数字にできます。
注意点は2つです。1つはつける人のくせで、だれにでも甘い人、いつも真ん中を選ぶ人、第一印象に引っぱられる人がいます。もう1つは目盛りの幅です。定規の1cmはどこでも同じ長さですが、「5と4」の差と「2と1」の差が同じとは限りません。
由来
| 年 | 主なできごと |
|---|---|
| 1920年 | Edward L. Thorndikeが、評定のハロー効果を報告 |
| 1920〜1923年 | Walter Dill Scottの会社でグラフ評定尺度が作られ、M. Freyd(1923)がまとめる |
| 1929年 | L. L. ThurstoneとE. J. Chaveが、判定者を使う態度測定法を発表 |
| 1932年 | Rensis Likertが、判定者のいらない態度測定法(リッカート法)を発表 |
| 1946年 | S. S. Stevensが、名義・順序・間隔・比率の4つの尺度水準を提案 |
| 1957年 | Charles E. Osgood、George J. Suci、Percy H. Tannenbaumが『The Measurement of Meaning』でSD法をまとめる |
具体的な説明
評定尺度の主な形式
| 形式 | しくみ | 例 |
|---|---|---|
| グラフ評定尺度(graphic rating scale) | 線分の上に段階の説明を添え、評定者が線上に印をつける | 人事評価。痛みを測る視覚的アナログ尺度(VAS)の源流とされる |
| リッカート法(Likert scale) | 意見文への賛否の程度を段階で答え、複数の項目の点数を合計(平均)する | 授業アンケート |
| SD法(semantic differential method) | 反対の意味の形容詞対を両端に置き、その間の段階で評価する | 「よい―わるい」「強い―弱い」 |
リッカート法
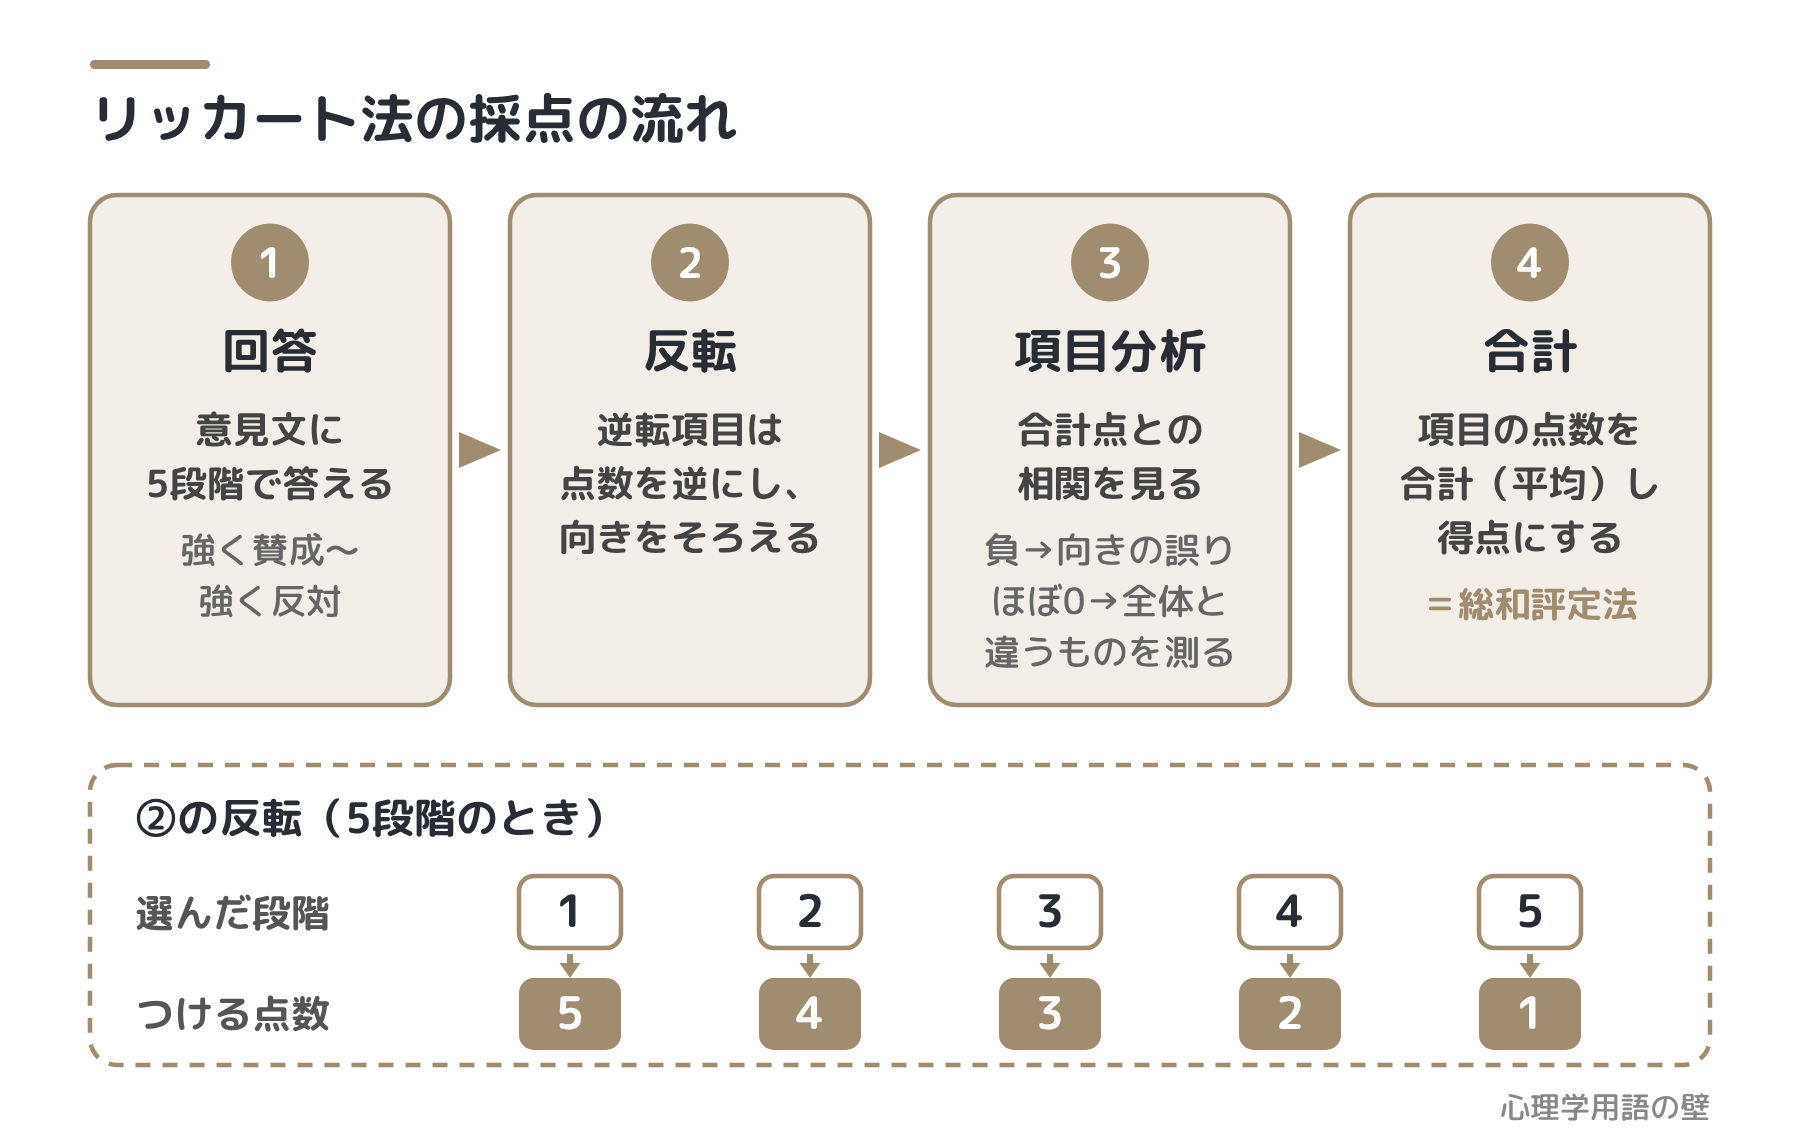
Likert(1932)は、国際関係などへの態度を「強く賛成(strongly approve)〜強く反対」の5段階で答えさせ、各選択肢に1〜5の連続した数値を割り当てて、合計か平均を得点としました。項目の得点を合計するので、日本では総和評定法とも呼ばれます。正規分布を仮定する複雑な採点法(シグマ法)とも、ほぼ同じ結果(相関+.99)でした。
判定者がいらない代わりに、次の工夫をしました。
- 項目分析:各項目と合計点の相関が負なら点数の向きの誤り、ほぼ0なら全体と違うものを測る項目とみなす。合計点の上位群と下位群の差も比べる
- 文の向きをまぜる:同じ側ばかり選ぶ機械的な回答を防ぐため、約半数の文は向きを逆にして、ばらばらに並べる(いわゆる逆転項目)
SD法
Osgoodらは、ことばや概念がもつ情緒的な意味(イメージ)を測るため、形容詞対の7段階尺度(両端から「非常に」「かなり」「やや」、中央が「どちらでもない」)を使いました。多くの形容詞対の評定を因子分析すると、主に次の3因子が見いだされました。
- 評価性(evaluation):よい―わるい、美しい―醜い など。いちばん大きな因子
- 力量性(potency):大きい―小さい、強い―弱い、重い―軽い など
- 活動性(activity):速い―遅い、能動的―受動的 など
段階数と中点
段階が少なすぎると細かい違いを区別できず、多すぎると迷います。奇数にすると「どちらでもない」という中点ができ、中立な人の受け皿にも、考えずに選ぶ逃げ道にもなります。偶数なら、どちらかに寄った回答を求めます。
評定の誤差
人が人を評定するときの代表的な誤差は、Thorndike(1920)が報告したハロー効果です。将校を「体格」「知性」「リーダーシップ」「人格」に分けて別々に評定するよう指示されていたのに、評定どうしの相関が高すぎ、そろいすぎていたのです。
| 誤差 | 内容 |
|---|---|
| 寛大化傾向(leniency) | 全体に甘く評定する(寛大効果とも)。逆は厳格化傾向 |
| 中心化傾向(central tendency) | 極端な評定を避け、中央付近に集める |
| ハロー効果(halo effect) | ある人の目立つ特徴や全体の印象が、その人のほかの項目にも及ぶ |
| 論理的誤差(logical error) | 評定者が「論理的に関係がある」と思いこんでいる特性どうしを似た評定にする(Newcomb, 1931) |
| 対比誤差(contrast error) | 評定者が自分と比べて評定する(Murray, 1938) |
ハロー効果は特定の人への印象が広がる誤差、論理的誤差は「積極的な人は指導力もあるはず」という特性どうしの思いこみによる誤差です。対策は、段階の意味を行動の例で示す、複数の評定者の平均を使う、などです。
順序尺度か、間隔尺度か
Stevens(1946)の尺度水準でいえば、評定値は、順番はわかっても間隔が等しいとは限らない順序尺度です。Stevensは、心理学の多くの尺度は順序尺度で厳密には平均や標準偏差を使うべきでないとしつつ、有益な結果が多いという「実用上の承認」も認めました。
Jamieson(2004)は、間隔尺度とみなす慣行を批判して中央値やノンパラメトリック検定を使うべきだと主張し、Norman(2010)は、パラメトリック検定はこうした仮定からのずれに頑健だと論じました。実際には合計点を間隔尺度とみなして分析することが多いものの、試験では「本来は順序尺度」が問われます。
信頼性と妥当性
作った尺度は、信頼性(内的整合性、再検査信頼性、評定者間の一致)と妥当性を確かめて使います。内的整合性にはCronbach(1951)のα係数がよく使われます。
実験や観察の方法と結論
方法 Preston & Colman(2000)は、149人に店やレストランのサービスを、段階数だけが違う尺度(2〜11段階と101段階)で評定してもらいました。
結論 2〜4段階は信頼性・妥当性・識別力の指標が比較的低く、約7段階までは段階が多いほど指標が高くなりました。内的整合性には差がなく、10段階を超えると再検査信頼性が下がる傾向がありました。
例文
「授業の満足度を評定尺度法(5段階)でたずね、逆転項目を反転させてから5項目を合計しました。」
「上司の評定がほとんど『普通』に集まっていたので、中心化傾向が疑われました。」
疑問
Q: 評定尺度は何段階にするのがよいのですか?
A: 唯一の正解はありません。7段階前後までは指標が上がるという研究もありますが、回答者や質問の内容、中点の有無も考えて決めます。
Q: リッカート法とSD法はどう違うのですか?
A: リッカート法は意見文への賛否の程度を合計して態度を測り、SD法は形容詞対の間で評価させて、対象のイメージを評価性・力量性・活動性などでとらえます。
Q: 逆転項目は、どうやって点数にするのですか?
A: 5段階なら「5→1、4→2、3→3、2→4、1→5」のように点数を反転させ、ほかの項目と向きをそろえてから合計します。
理解度を確認する問題
問題1. 評定尺度法にかかわる技法の説明として、最も適切なものはどれか。
- A. リッカート法では、多数の判定者に意見文を分類させ、各文の尺度値を決めてから使う
- B. SD法では、形容詞対の評定の因子分析から評価性・力量性・活動性の3因子が見いだされ、最も大きいのは評価性だった
- C. SD法は、意見文への賛否の程度を合計することから、総和評定法とも呼ばれる
- D. Likert(1932)は、1〜5点を割り当てる単純な採点はシグマ法と大きく食い違うため、使えないと結論した
正解:B SD法はOsgoodらの方法で、最大の因子は評価性です。AはThurstoneの方法で、判定者がいらないのがリッカート法の長所です。Cはリッカート法の説明です。Dは逆で、Likertは単純な採点がシグマ法とほぼ同じ結果(相関+.99)になることを示しました。
問題2. 面接官Xは、応募者Pのはきはきした話し方が印象に残り、Pの「計画性」「誠実さ」まで高く評定した。面接官Yは「積極的な人は指導力も高いはずだ」と考え、どの応募者でも「積極性」と「指導力」を同じように評定した。X、Yに生じている誤差の組み合わせとして、最も適切なものはどれか。
- A. X:論理的誤差 Y:ハロー効果
- B. X:ハロー効果 Y:論理的誤差
- C. X:寛大化傾向 Y:中心化傾向
- D. X:対比誤差 Y:ハロー効果
正解:B Xは、Pという特定の人への印象がほかの項目に広がっているのでハロー効果です。Yは、だれに対しても特性どうしの思いこみで評定しているので論理的誤差です。Aは逆です。Cは甘くつける傾向と中央に集める傾向で、事例に合いません。Dの対比誤差は評定者が自分と比べる誤差です。
問題3. 評定尺度と尺度水準に関する記述として、最も適切なものはどれか。
- A. 5段階評定の「4」は「2」の2倍の強さを表すので、評定値は比率尺度である
- B. 評定値は本来は順序尺度だが、実際の研究では合計点を間隔尺度とみなして平均などを使うことが多い
- C. 間隔尺度のデータには、ノンパラメトリック検定を使うことができない
- D. 段階数を7段階以上にすれば、選択肢の間隔が等しいことが保証され、間隔尺度になる
正解:B Stevens(1946)も「実用上の承認」を認めていました。Aは誤りで、評定値には絶対的な原点(0)がなく、間隔が等しいとも限りません。Cは誤りで、間隔尺度のデータも順位に直せばノンパラメトリック検定を使えます。Dはまぎらわしいですが誤りで、段階を増やしても間隔の等しさは保証されません。
関連キーワード
- リッカート法(Likert Scale)
- SD法(Semantic Differential Method)
- 尺度水準(Levels of Measurement)
- ハロー効果とホーン効果
- パラメトリック検定/ノンパラメトリック検定(Parametric Test / Nonparametric Test)
- 因子分析(いんしぶんせき)
- 測定変数(Measurement Variables)
- 虚偽尺度(Lie Scale)
関連論文
まずこの1本
Likert, R.(1932)A technique for the measurement of attitudes. Archives of Psychology, No. 140, 1–55.
リッカート法の原典で、単純な1〜5点の採点、判定者が不要なこと、項目分析による項目選びを示しました。試験ではLikert=賛否の程度の合計(総和評定法)、Thurstone=判定者が文を分類、Osgood=SD法の対応を押さえましょう。DOIがないため原典のスキャンを示します。
https://archive.org/details/likert-1932その他の参考文献
Saal, F. E., Downey, R. G., & Lahey, M. A.(1980)“Rating the ratings: Assessing the psychometric quality of rating data.” Psychological Bulletin, 88(2), 413–428.
概要 ハロー、寛大化・厳格化、中心化傾向などの評定誤差の歴史と定義、測り方をまとめた論文です。
https://doi.org/10.1037/0033-2909.88.2.413ほそめがねのひとこと
アンケートで「どちらでもない」をよく選びますか?私は選んじゃいます。 皆さんのご意見もひとことでどうぞ。
覚え方
①提唱者:「賛否のリッカート、形容詞のオズグッド」。意見文への賛否がリッカート法、形容詞対がSD法です。
②SD法の3因子:「ヒョウ(評価)はリキ(力量)があってカツ(活動)やく」。いちばん大きいのは評価性です。
③評定の誤差:「甘い・真ん中・後光・思いこみ」。寛大化傾向・中心化傾向・ハロー効果(halo=後光)・論理的誤差の順です。
コメント