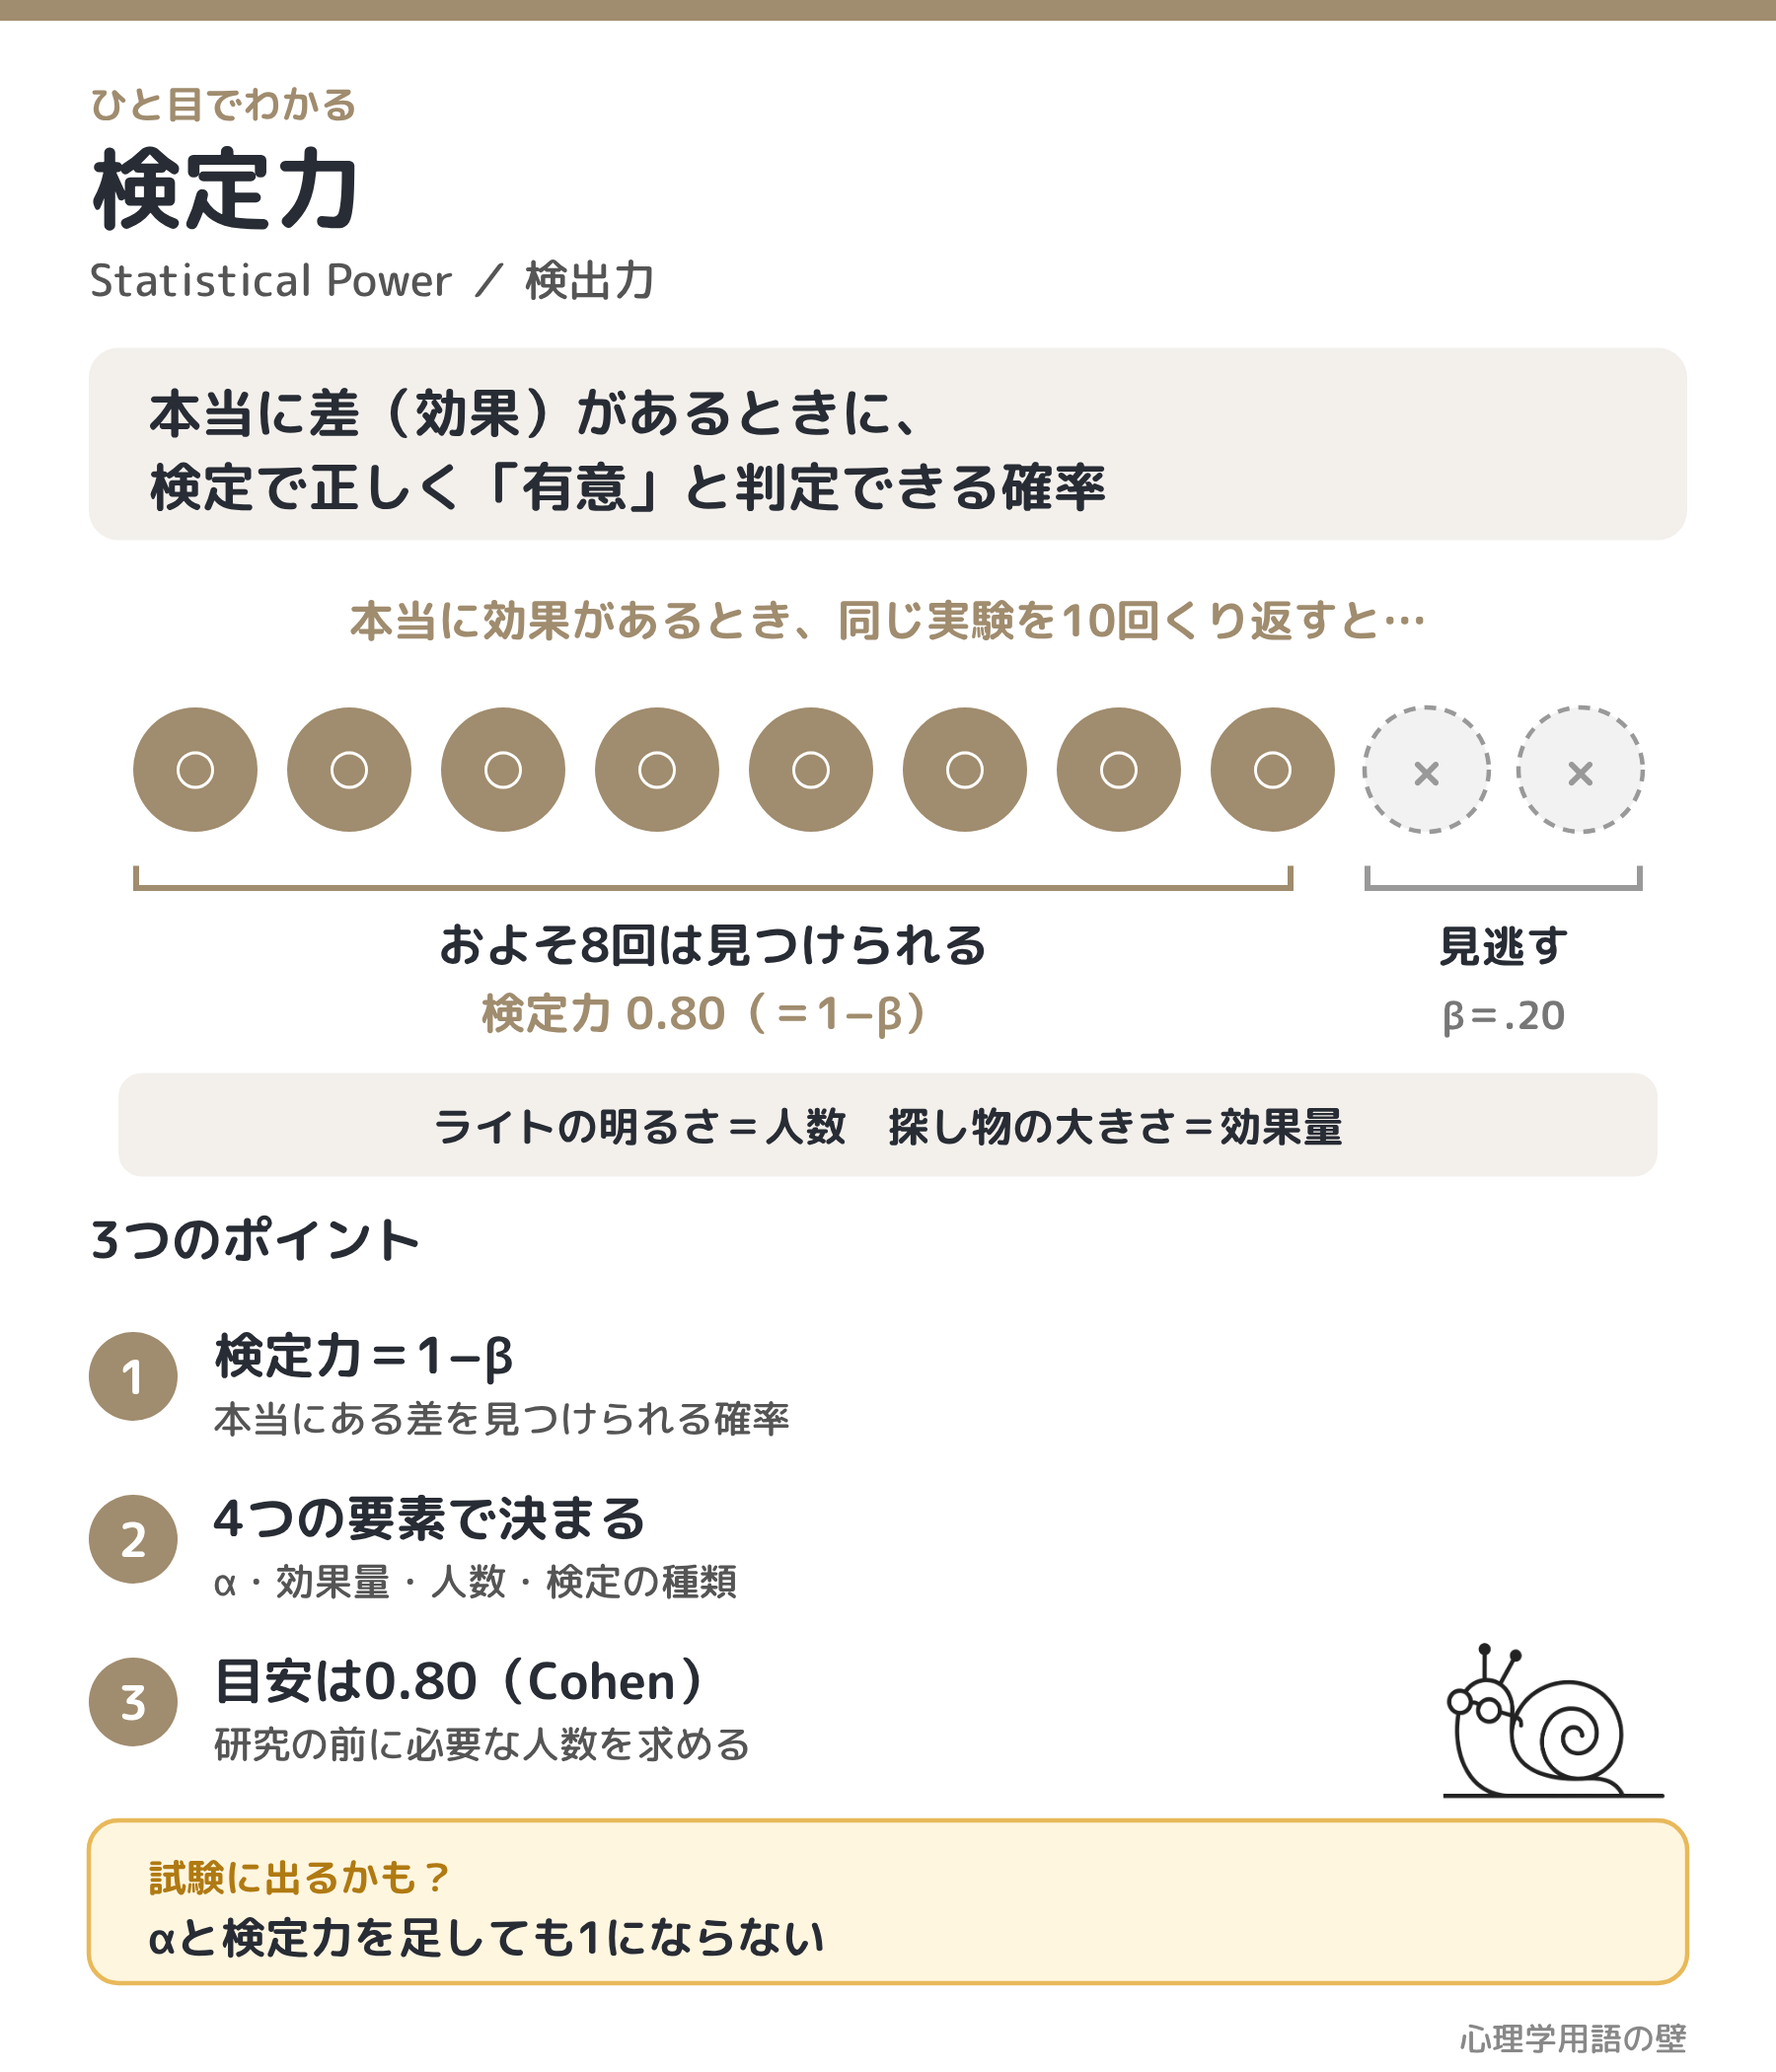
検定力(Statistical Power)とは、本当に差(効果)があるときに、検定で正しく「有意」と判定できる確率です。第2種の誤りの確率をβとすると、検定力は1−βで表されます。「検出力」とも訳されます。
簡単な説明
暗い部屋で、落としたイヤリングを懐中電灯で探す場面を想像してください。イヤリングは確かに床にあるのに、ライトが弱かったり、イヤリングが小さかったりすると、「ない」とあきらめてしまうかもしれません。
心理学の実験も同じです。勉強法に本当に効果があっても、参加者が少なすぎると有意にならず、見逃すことがあります。本当にあるものを見つけられる確率が検定力です。ライトの明るさにあたるのが参加者の人数(サンプルサイズ)、イヤリングの大きさにあたるのが効果の大きさです。検定力0.80なら「効果が本当にあるとき、同じ実験を10回くり返すと、およそ8回は見つけられる」という意味になります。
由来
| 年 | 主なできごと |
|---|---|
| 1933年 | Jerzy NeymanとEgon S. Pearsonが、最も効率のよい検定を論じた論文を発表。帰無仮説と対立仮説を立て、2種類の誤りを考える枠組みから検定力の考え方が生まれました |
| 1962年 | Jacob Cohenが、心理学の論文の検定力を調べ、多くが低いことを示しました |
| 1969年 | Cohenが『Statistical Power Analysis for the Behavioral Sciences』を出版(1977年改訂版、1988年第2版)。検定力0.80を目安とする慣例を示しました |
具体的な説明
2種類の誤りと検定力
検定の判定と「本当の状態」の組み合わせは4通りです。
| 検定の判定 | 本当は差がない(帰無仮説が真) | 本当は差がある(帰無仮説が偽) |
|---|---|---|
| 有意(帰無仮説を棄却) | 第1種の誤り(確率α) | 正しい判定(確率1−β=検定力) |
| 有意でない(棄却しない) | 正しい判定(確率1−α) | 第2種の誤り(確率β) |
αは研究者が前もって決める有意水準(ふつう.05)です。βは効果の大きさや人数で変わります。縦の列ごとに合計が1になる点に注意しましょう。αと検定力は別の列なので、足しても1になりません。
検定力を決める4つの要素
| 要素 | 検定力が上がる方向 | 注意点 |
|---|---|---|
| 有意水準α | αを大きくする(.01→.05) | 第1種の誤りが増える |
| 効果量 | 効果が大きい | 研究者は選べないが、測定誤差を減らすと大きくなる |
| サンプルサイズ | 人数を増やす | 研究者が最も調整しやすい |
| 検定の種類 | 方向が正しい片側検定、個人差を除ける対応のある計画 | 片側にするかはデータを見る前に決める |
効果量の指標と目安は「効果量」の記事にまとめています。
人数を増やすと検定力はどう変わるか
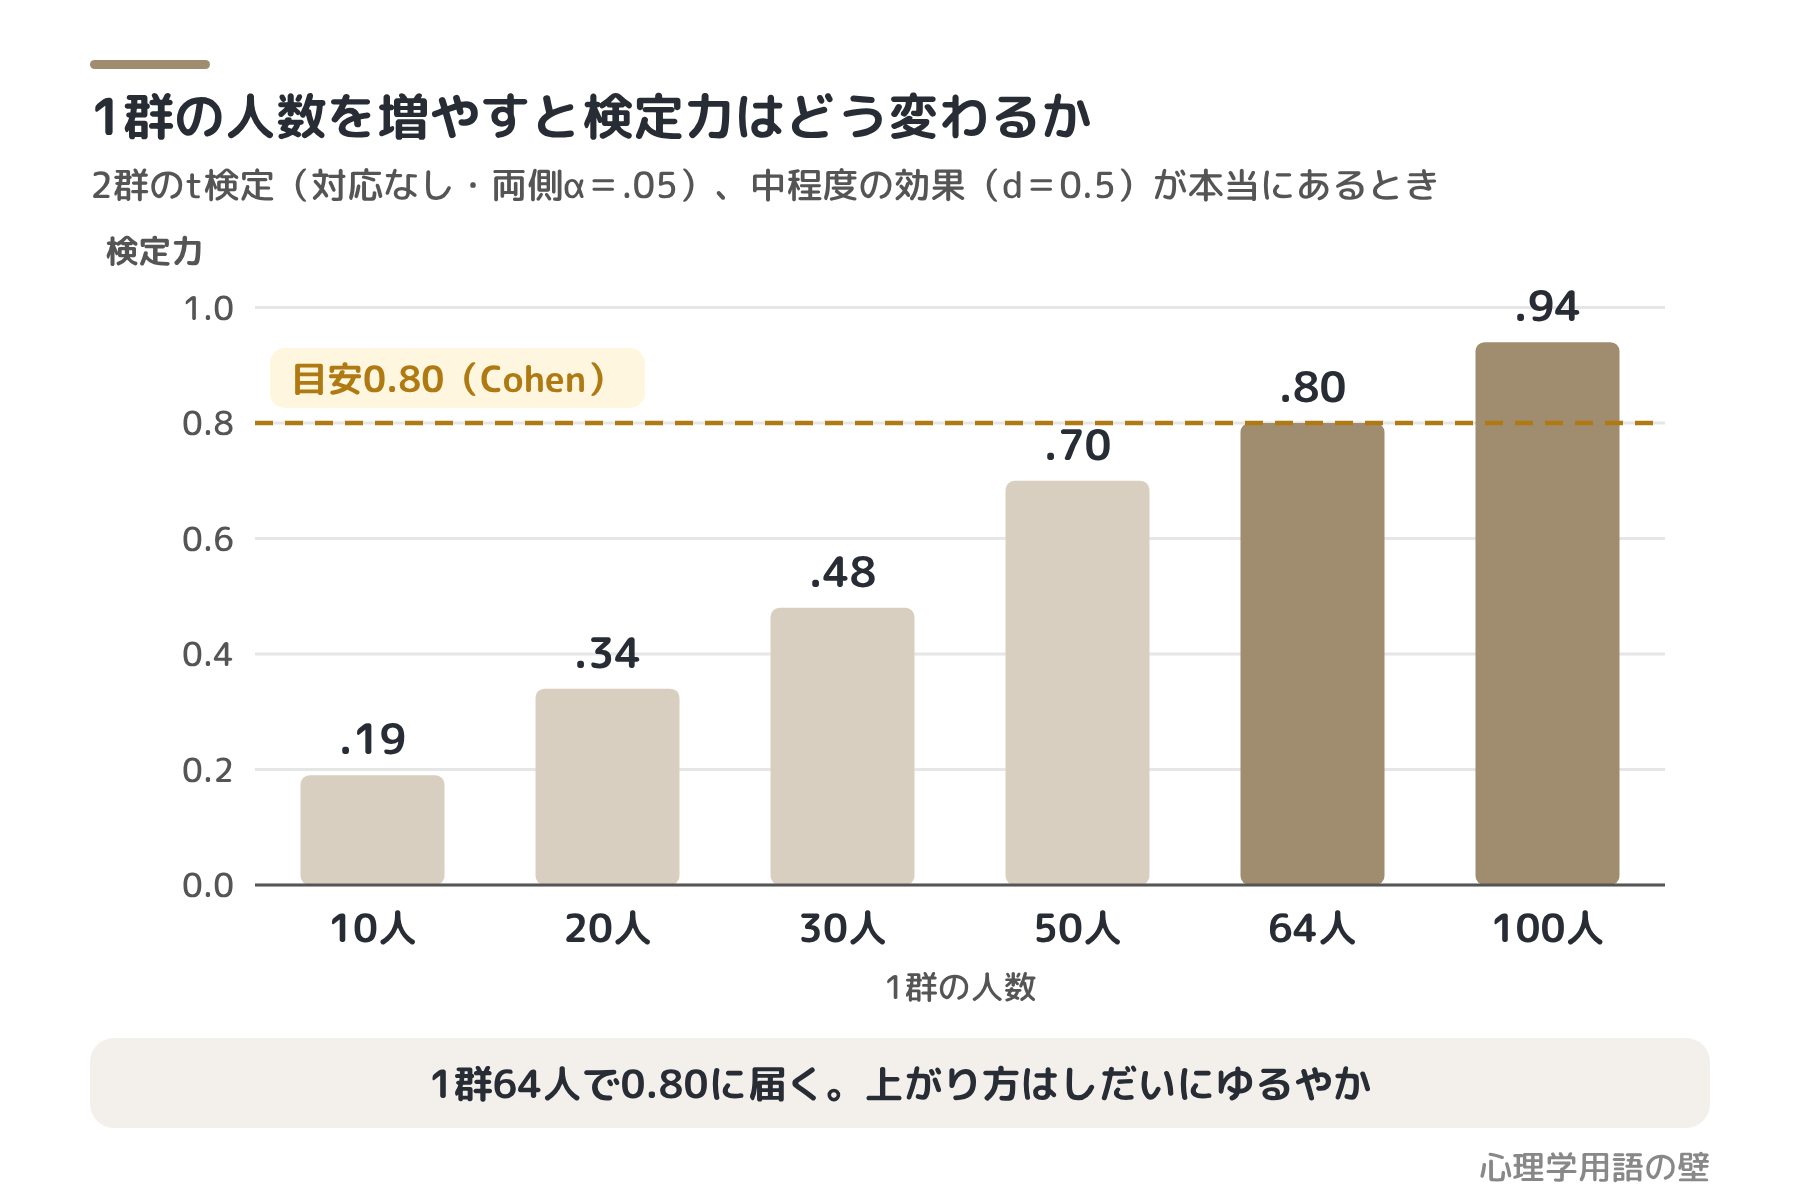
2群の平均を比べるt検定(対応なし・両側α=.05)で、中程度の効果(d=0.5)が本当にあるときの検定力は次のとおりです。
| 1群の人数 | 10人 | 20人 | 30人 | 50人 | 64人 | 100人 |
|---|---|---|---|---|---|---|
| 検定力 | .19 | .34 | .48 | .70 | .80 | .94 |
1群20人では3回に2回ほど見逃します。人数を増やすほど上がりますが、上がり方はしだいにゆるやかです。同じ64人でも、αを.01にすると約.59に下がり、片側検定にすると約.88に上がります。
目安0.80と事前の検定力分析
Cohenは、一般的な目安として検定力0.80(β=.20)を提案しました。α=.05と組み合わせると、2種類の誤りのリスクの比(β:α)は4:1です(Cohen, 1992)。絶対の基準ではありません。
研究の前に、α・想定する効果量・目標の検定力から必要な人数を求めることを事前の検定力分析といいます。上の表なら「1群64人」です。検定力は、データではなく研究計画の性質です。
検定力が低いと「有意な結果」も信用しにくくなる
低検定力の害は見逃しだけではありません。John P. A. Ioannidis(2005)は、有意な結果が本物である確率(PPV)を、α・検定力・本当に効果がある仮説の割合から求める式を示しました。調べる仮説100個のうち20個に効果があり、α=.05として計算すると次のとおりです。
| 検定力 | 本物の有意(20×検定力) | 偽物の有意(80×.05) | 有意が本物の割合 |
|---|---|---|---|
| .80 | 16個 | 4個 | 80% |
| .20 | 4個 | 4個 | 50% |
検定力が低いと「有意」の半分が偽物になりえます。また小さな研究では、たまたま大きく出た効果だけが有意になるため、効果が過大に見積もられやすくなります。
事後検定力(observed power)の落とし穴
データを取ったあと、得られた効果量で計算した検定力が事後検定力です。John M. HoenigとDennis M. Heisey(2001)は、事後検定力はp値と1対1に対応するのでp値以上の情報を持たず、有意でない結果では必ず低くなると指摘しました。「有意でないが事後検定力が高いので差はない」という推論は成り立たず、代わりに信頼区間や同等性検定を使うよう勧めています。
実験や観察の方法と結論
研究1:Cohen(1962)の文献調査
方法:『Journal of Abnormal and Social Psychology』1960年の巻に載った論文について、「小・中・大の効果があったとしたら」という前提で各検定の検定力を計算しました。
結論:平均の検定力は、小さい効果で約.18、中程度の効果で約.48、大きい効果で約.83でした。中程度の効果でも、半分以上を見逃しうる計画でした。
研究2:Button et al.(2013)の「低検定力」問題
方法:2011年に発表された神経科学のメタ分析49本(含まれる研究730本)で、メタ分析の効果量を本当の効果と仮定して検定力を推定しました。
結論:検定力の中央値は約21%でした。低検定力は効果の過大推定と再現性の低さを招き、資源のむだという倫理的な問題もあると論じました。
例文
「1群15人の予備実験では有意差が出ませんでしたが、検定力が低かった可能性があるため、検定力分析で人数を決め直して本実験を行いました。」
「研究計画書には、想定する効果量・有意水準・目標の検定力0.80と、そこから求めた必要なサンプルサイズを書きます。」
疑問
Q: 有意差が出なければ、「差はない」と考えてよいのですか?
A: いいえ。検定力が低いと、本当は差があっても有意にならないことがよくあります。有意でないのは「差があるとは言えなかった」という意味です。差の大きさの範囲は信頼区間で確かめましょう。
Q: 小さな研究でも有意になったのなら、検定力が低くても問題ないのでは?
A: そうとは限りません。上の計算例のように、検定力が低いと有意な結果のうち偽物の割合が増え、効果も大きめに報告されがちです。追試で効果が小さくなったり消えたりする一因です。
Q: 人数は多ければ多いほどよいのですか?
A: 検定力は上がりますが、人数がとても多いと実用上意味のない小さな差でも有意になり、参加者の負担や費用も増えます。事前の検定力分析で「必要十分な人数」を決めるのが基本です。
理解度を確認する問題
問題1. 本当は効果がある指導法を、1群15人の実験で検証したところ、有意差が得られなかった。この結果の解釈として、最も適切なものはどれか。
- A. 第1種の誤りが起きたと考えられる
- B. 第2種の誤りが起きたと考えられ、検定力が不足していた可能性がある
- C. 有意差がなかったので、指導法に効果がないことが示された
- D. 得られたデータから事後検定力を計算すれば、効果がないかどうかを確かめられる
正解:B 本当は差があるのに有意にならなかったので第2種の誤り(確率β)で、1群15人では検定力不足が考えられます。Aは逆で、第1種の誤りは差がないのに有意と判定することです。Cは「有意でない=差がない」というよくある誤りです。Dはまぎらわしいですが誤りで、事後検定力はp値と1対1に対応し、有意でない結果では必ず低く出ます(Hoenig & Heisey, 2001)。
問題2. ほかの条件を同じにしたとき、検定力を下げる操作として、最も適切なものはどれか。
- A. 1群あたりの参加者を30人から60人に増やす
- B. 第1種の誤りを減らすために、有意水準を.05から.01に変える
- C. 信頼性の高い尺度に変えて、測定の誤差を小さくする
- D. 予測した方向が正しいときに、両側検定ではなく片側検定を使う
正解:B αを小さくすると基準が厳しくなり、第1種の誤りは減りますが、βが増えて検定力は下がります。「誤りを減らす」という言葉に引っぱられないことがポイントです。A・C・Dはいずれも検定力を上げる方向です。
問題3. 検定力に関する説明として、最も適切なものはどれか。
- A. 検定力が0.80の研究で有意な結果が出たら、その結果が本当の効果である確率は80%である
- B. 有意水準αと検定力は、足すと必ず1になる
- C. 検定力が低い研究では、有意な結果が得られても、それが本当の効果である確率が低くなる
- D. Cohen(1962)の調査では、中程度の効果に対する平均の検定力は.80を上回っていた
正解:C Button et al.(2013)の指摘です。Aはまぎらわしいですが誤りで、検定力は「効果があるときに有意になる確率」です。有意な結果が本物である確率は、本当に効果がある仮説の割合にも左右されます。Bは誤りで、αは「差がない」とき、検定力は「差がある」ときの確率です(足して1になるのはβと検定力)。Dは誤りで、約.48でした。
関連キーワード
- 第1種の誤り/第2種の誤り(Type I Error / Type II Error)
- 有意水準(Significance Level)
- 効果量(Effect Size)
- t検定(t-test)
- メタ分析(meta-analysis)
- 出版バイアス(publication bias)
- 疑わしい研究実践(Questionable Research Practices: QRPs)
関連論文
まずこの1本
Cohen, J.(1962)The statistical power of abnormal-social psychological research: A review. The Journal of Abnormal and Social Psychology, 65(3), 145–153.
心理学の研究の検定力を調べた先駆けの論文です。小・中・大の効果を仮定して計算した点が特徴です。試験対策としては、検定力=1−β、目安0.80、心理学の研究は検定力が低いことが多いという3点を、Cohenの名前と結びつけて押さえましょう。
https://doi.org/10.1037/h0045186その他の参考文献
Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R.(2013)“Power failure: Why small sample size undermines the reliability of neuroscience.” Nature Reviews Neuroscience, 14(5), 365–376.
概要 神経科学の研究の検定力の中央値が約21%と低いことを示し、その害を論じた論文です。
解説 見逃しだけでなく「有意な結果が本物である確率も下がる」点が、再現性の議論で問われやすいポイントです。
https://doi.org/10.1038/nrn3475ほそめがねのひとこと
第1種の誤りと第2種の誤り、どちらがαでどちらがβか復習します。
覚え方
①「あわてんぼうのα、ぼんやりのβ」。差がないのに「ある」と言うのがあわてんぼう(第1種の誤り・α)、差があるのに見逃すのがぼんやり(第2種の誤り・β)です。検定力は、ぼんやりしない確率=1−βです。
②懐中電灯のイメージ。ライトを明るく(人数を増やす)、探し物が大きい(効果が大きい)、範囲をしぼる(片側検定)、基準をゆるめる(αを大きく)と見つかりやすくなります。
③「パワーは8割、βは2割」。検定力0.80とβ=.20をセットで覚えます。
コメント